Pinterest apresentou um mecanismo de finalização de partição baseado em event time para seu framework de ingestão de dados de próxima geração, resolvendo um desafio fundamental em arquiteturas de streaming em larga escala.
O sistema utiliza Apache Flink para medir progresso de event time e Apache Iceberg para publicar um watermark de finalização não-regressivo. Essa abordagem permite que jobs downstream determinem quando dados em ingestão contínua estão suficientemente completos para processamento. A solução endereça um problema crítico na ingestão contínua de Change Data Capture (CDC), onde registros podem chegar após o intervalo de wall clock da partição ter encerrado.
O framework de ingestão do Pinterest integra CDC, Kafka, Flink, Spark e Iceberg para transportar mudanças de bancos de dados MySQL, TiDB e KVStore para tabelas analíticas. A plataforma suporta dados em escala de petabyte e gerencia milhares de pipelines, com mudanças online tipicamente disponíveis entre 15 minutos e uma hora.
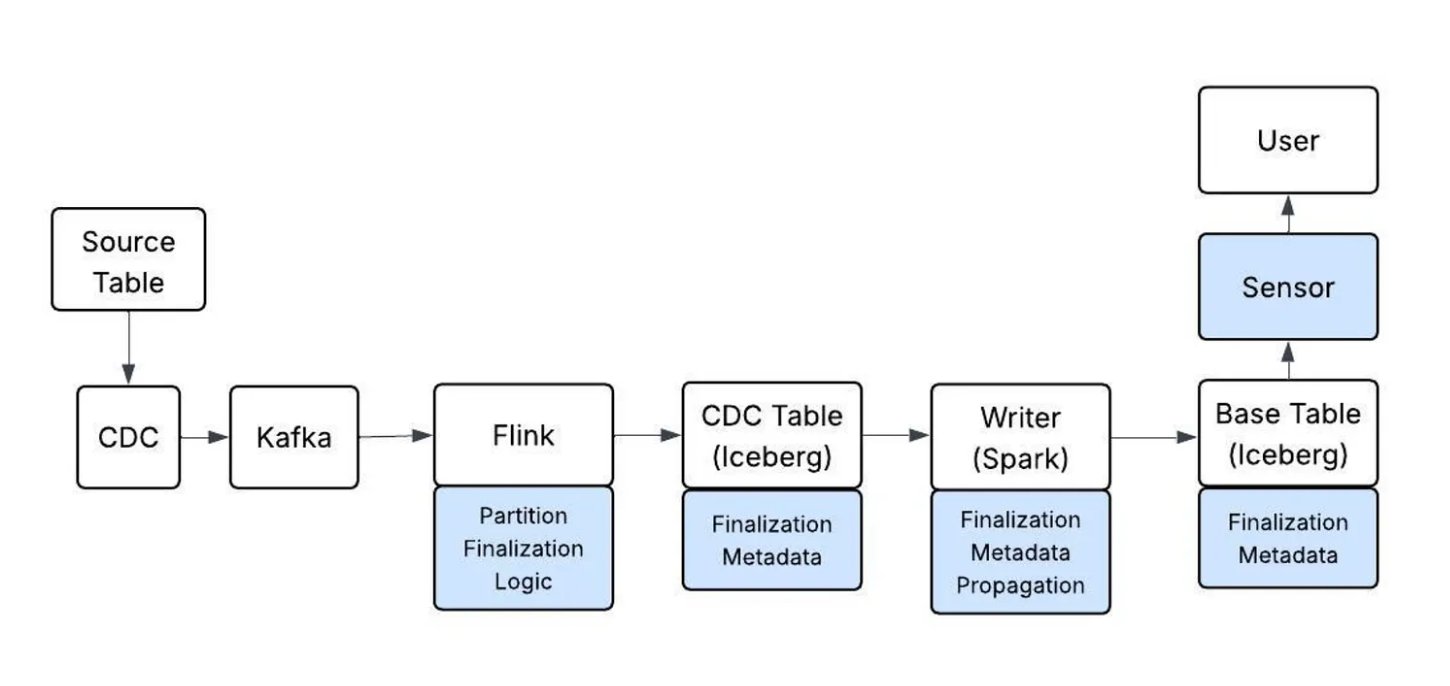
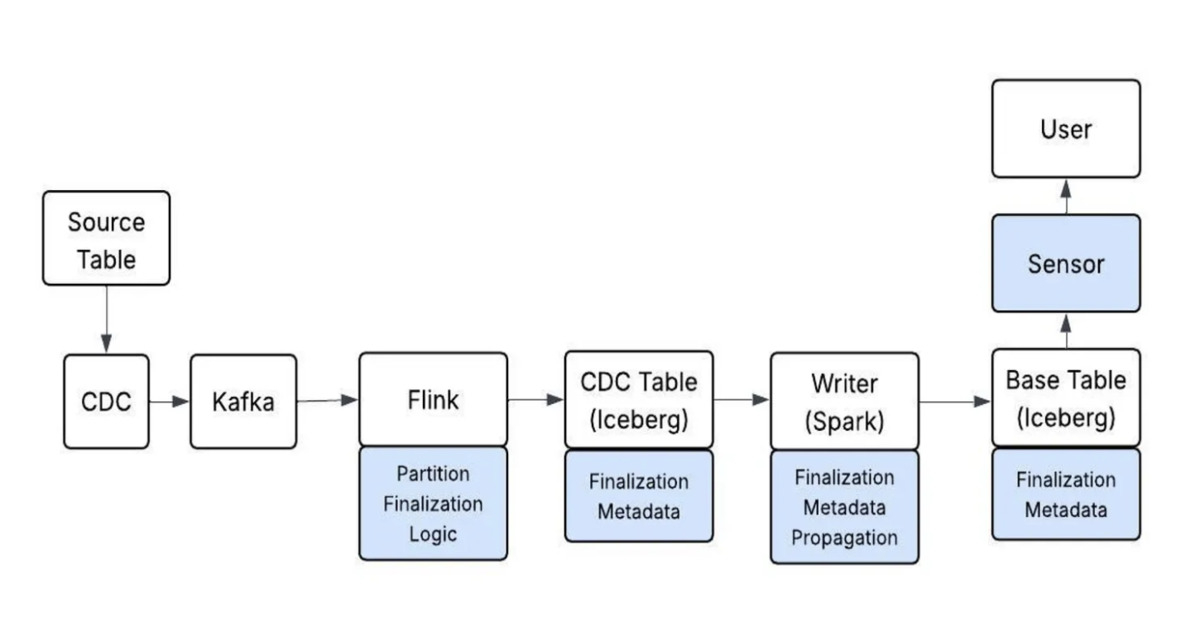
Imagem: InfoQ. Arquitetura do Pinterest mostrando eventos CDC do Kafka fluindo através do Flink para uma tabela CDC Iceberg
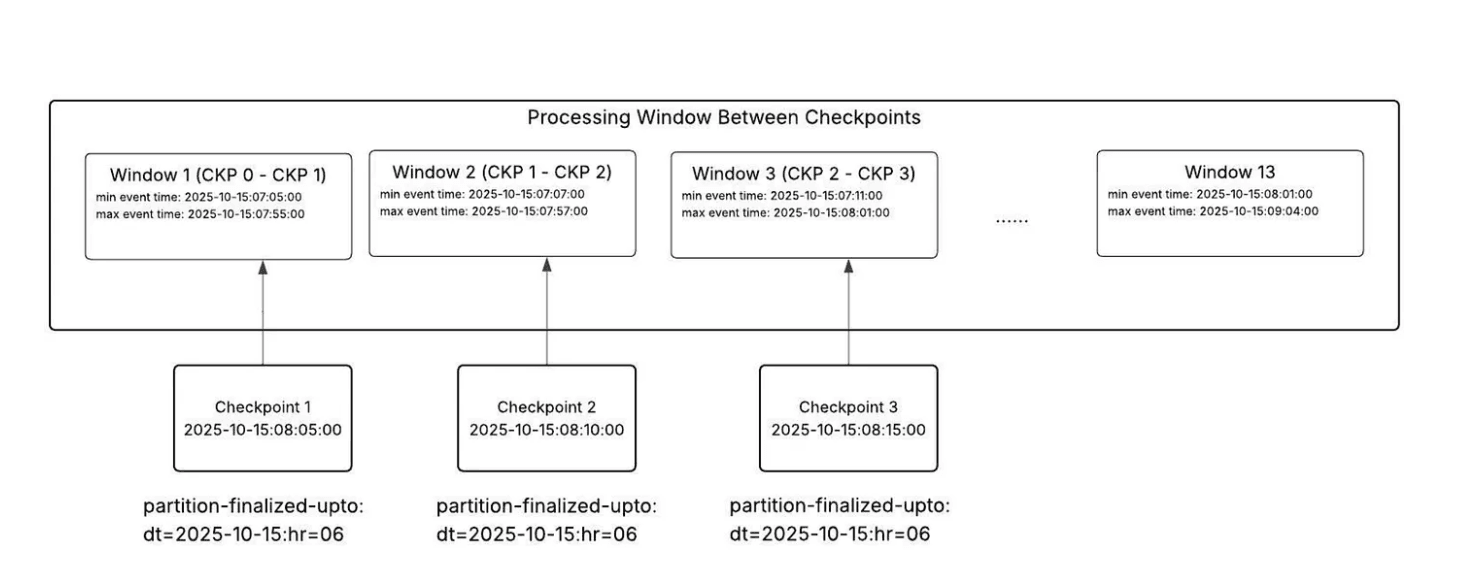
Diferentemente da abordagem anterior baseada em lotes, onde a conclusão de um job indicava que uma partição estava pronta para leitura, a ingestão em streaming realiza commits contínuos sem um ponto de conclusão equivalente. O novo mecanismo executa dentro do sink de Flink para Iceberg. Para cada registro CDC, o sistema extrai um event time configurado.
Durante checkpoints do Flink, a solução coleta estatísticas de event time mínimo, máximo e percentil. Essas métricas são armazenadas no snapshot summary do Iceberg com um t-digest representando a distribuição em poucas centenas de bytes. Após cada commit do Iceberg, o sistema calcula um watermark de finalização de partição a partir de estatísticas de checkpoints recentes.
A política padrão utiliza o event time mínimo através de um número configurável de commits recentes e o arredonda para a hora relevante. O watermark é monotônico, prevenindo que registros que chegam tardiamente movam um valor já publicado para trás. Políticas baseadas em percentil podem trocar alguma completude por dados mais frescos.
O watermark é armazenado como propriedade de tabela Iceberg, permitindo que sensores downstream o leiam sem exigir um serviço de coordenação separado. O Spark também propaga os metadados para a tabela base durante commits de upsert CDC. A implementação aproveita pontos de extensibilidade no sink Flink-to-Iceberg, onde accumulators coletam estatísticas de registros e commit processors executam lógica de finalização ao redor de commits do Iceberg.