A arquitetura de sistemas distribuídos está passando por uma transformação fundamental, migrando do paradigma consolidado de microsserviços para sistemas baseados em inteligência artificial agêntica. Essa evolução, impulsionada por avanços em modelos de linguagem grandes e sistemas de raciocínio, redefine como as organizações decompõem, executam e monitoram sistemas em larga escala.
Da Decomposição de Funcionalidade para Decomposição de Decisões
Microsserviços resolveram um problema central: como decompor funcionalidade entre serviços mantendo confiabilidade e permitindo evolução independente. Introduziram fronteiras explícitas de serviço, APIs bem definidas e fluxos de execução previsíveis. A sequência de operações de uma requisição é conhecida antecipadamente e codificada na lógica do sistema.
Sistemas agênticos funcionam diferentemente. Em vez de executar lógica predefinida, determinam dinamicamente quais ações tomar, quais ferramentas usar e como sequenciar processos de raciocínio multi-etapa. A execução não é totalmente especificada em tempo de design, mas emerge em tempo de execução baseada em contexto, objetivos e resultados intermediários. Isso representa uma mudança de decomposição de serviço para decomposição de decisão, distribuindo raciocínio entre componentes que participam de loops dinâmicos de decisão.
Esta transformação traz flexibilidade e capacidade de adaptação, mas reduz previsibilidade. Substitui workflows estáticos por caminhos de raciocínio dinâmicos, inerentemente mais difíceis de rastrear e depurar.
Dimensões Fundamentais de Diferença
Sistemas agênticos diferem de arquiteturas distribuídas tradicionais em três dimensões críticas.
Controle de fluxo: Em microsserviços, caminhos de execução são projetados e codificados antecipadamente. Em sistemas agênticos, são determinados em tempo de execução baseados em contexto e raciocínio intermediário. Diferentes requisições podem disparar caminhos de execução completamente distintos dependendo da intenção do usuário, informação recuperada ou decisões prévias.
Gerenciamento de estado: Sistemas tradicionais dependem de transições de estado explícitas e modelos de persistência bem definidos. Sistemas agênticos operam sobre contexto de execução continuamente atualizado conforme o raciocínio progride. Este contexto pode incluir histórico de conversa, planos intermediários, documentos recuperados, sinais de ranking, saídas de ferramentas e resultados de avaliação anterior. Gerenciar esse contexto fluido torna-se preocupação central: deve propagar entre múltiplos agentes, ferramentas e serviços mantendo consistência suficiente para suportar raciocínio downstream coerente.
Semântica de falha: Falhas tradicionais são binárias: uma requisição sucede ou falha. Em sistemas agênticos, falhas frequentemente manifestam-se como degradação de qualidade de decisão. O sistema pode continuar operando mas produzir resultados subótimos devido a raciocínio incorreto, seleção pobre de ferramentas, contexto desatualizado ou interpretação incompleta de resultados intermediários.
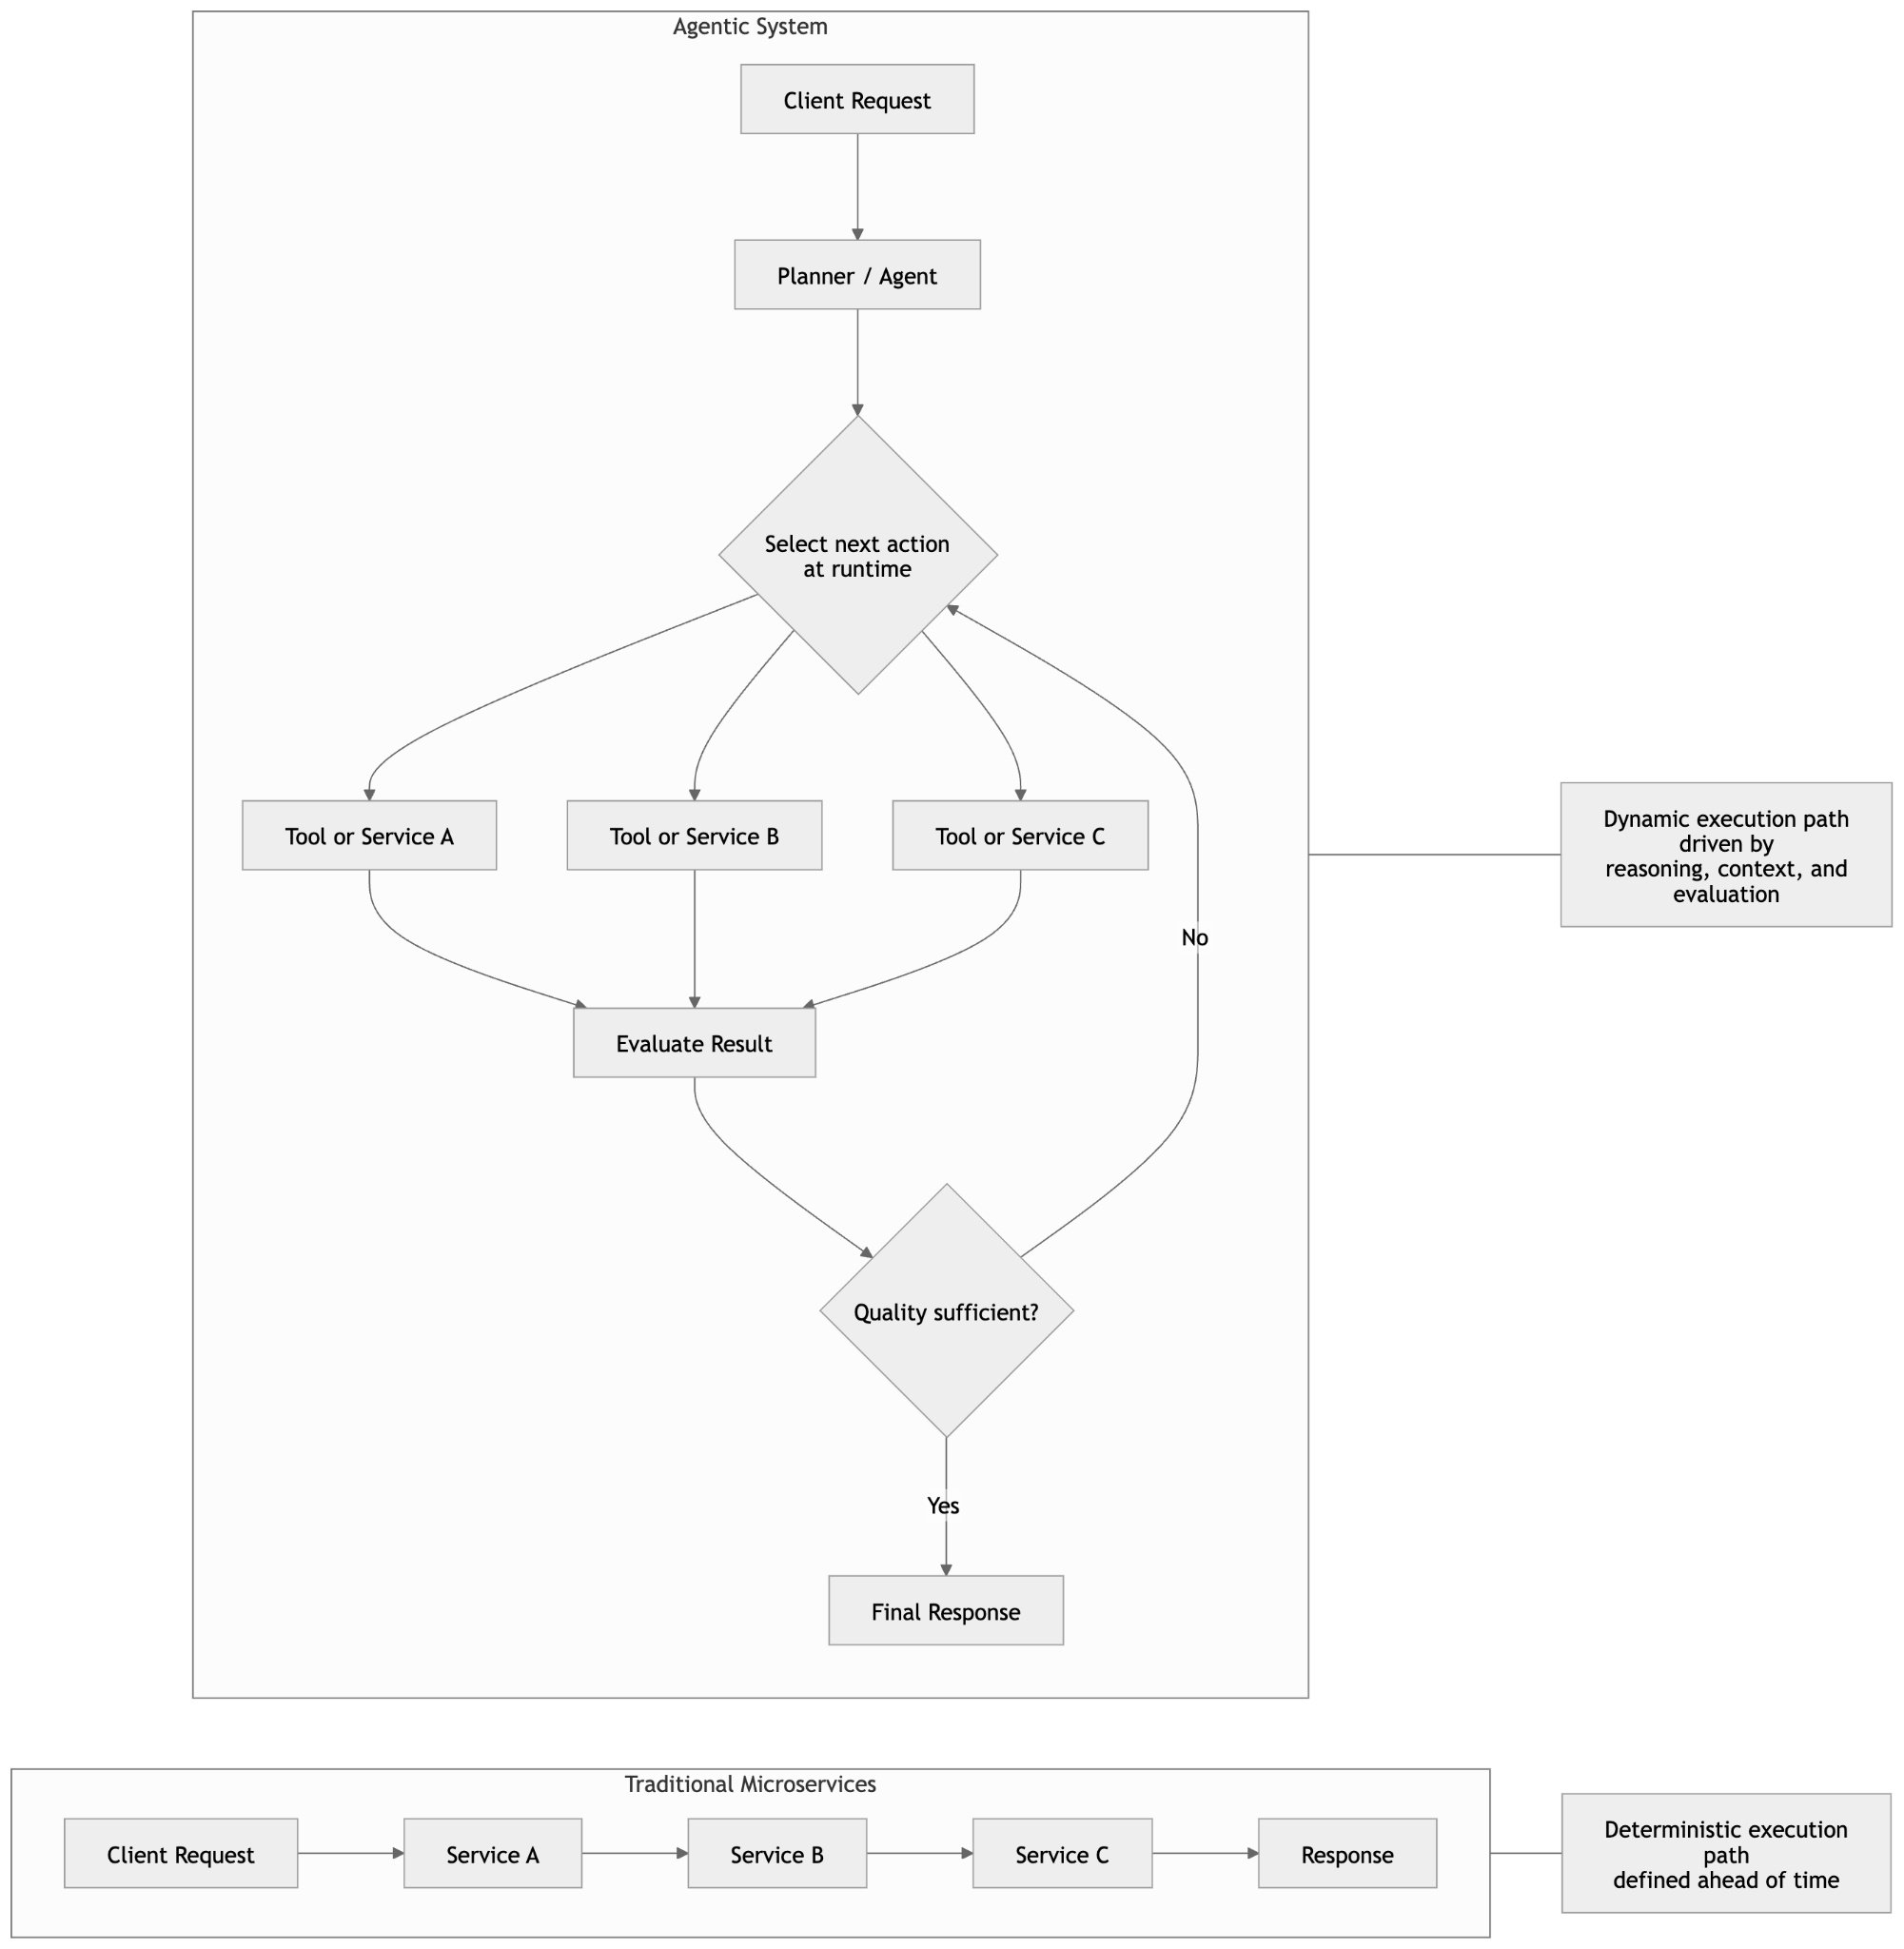
Imagem: InfoQ. Comparação de modelo de execução entre microsserviços, onde o controle de fluxo é fixo e previsível, e sistemas agênticos, onde o controle de fluxo é adaptativo e determinado em tempo de execução
Padrões Arquiteturais Emergentes
Conforme sistemas agênticos aparecem em ambientes de produção, padrões arquiteturais recorrentes estão emergindo.
Separação de planejamento e execução: Um componente de planejamento interpreta intenção e determina estratégia de alto nível, enquanto componentes de execução realizam operações determinísticas como recuperação de dados, transformação ou ranking. Essa separação isola raciocínio não-determinístico da execução determinística, melhorando confiabilidade e rastreabilidade.
Especialização de agentes: Em vez de confiar em agentes de propósito geral único, sistemas compostos de múltiplos agentes especializados, cada responsável por capacidade distinta (recuperação, ranking, avaliação, orquestração), colaboram para produzir resultados finais. Esta estrutura assemelha-se a decomposição de serviço em microsserviços mas aplicada a tomada de decisão em vez de lógica de processamento de dados. Aumenta qualidade de raciocínio e modularidade mas introduz sobrecarga de coordenação e complexidade aumentada. Latência torna-se mais variável e modos de falha podem propagar entre interações de agentes.
Integração de avaliação em loops de execução: Sistemas avaliam saídas durante tempo de execução em vez de tratá-la como processo offline. Baseado em resultados de avaliação, sistemas podem dinamicamente refinar, retentar ou ajustar estratégias. Introduz feedback loops em execução, permitindo comportamento mais adaptativo, mas requer controle cuidadoso para evitar retries excessivos ou ciclos de execução descontrolados.
Camadas de abstração de ferramentas: Conforme agentes interagem com crescente número de serviços e APIs, equipes criam interfaces padronizadas para uso de ferramentas. Essas camadas de abstração desacoplam raciocínio de agente de implementações de serviço subjacentes e fornecem mecanismo consistente para descoberta de capacidades e invocação.
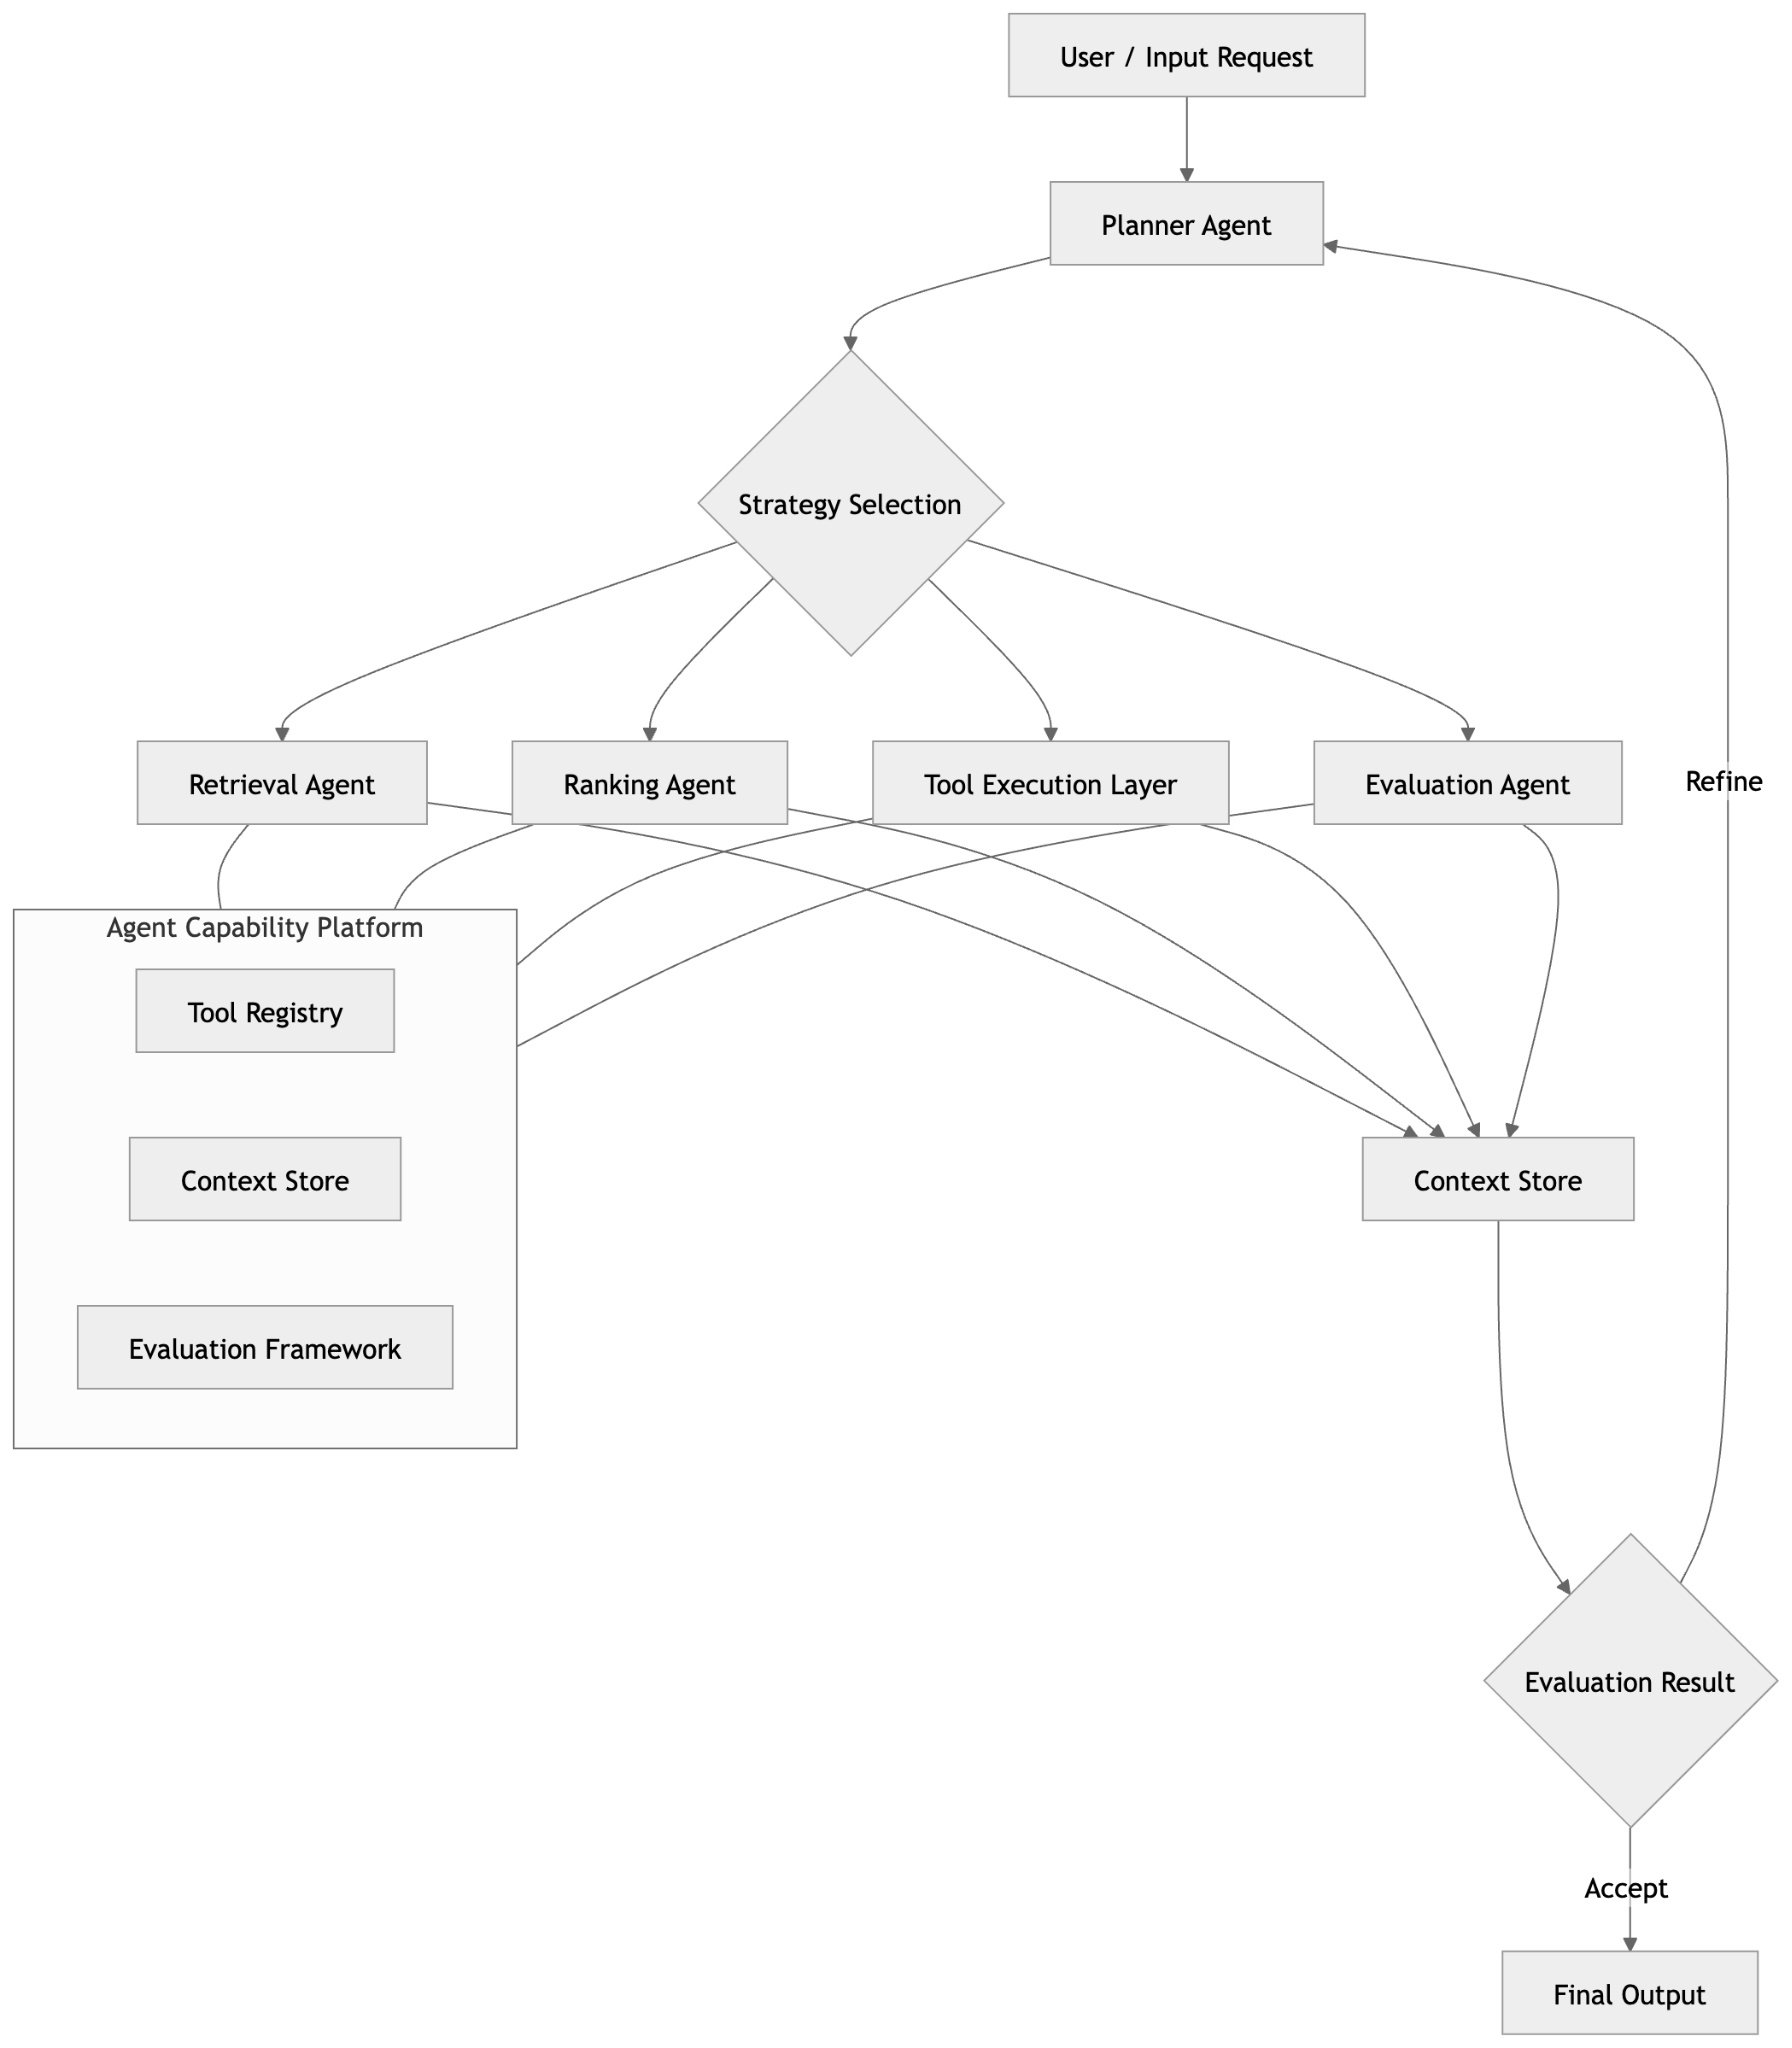
Imagem: InfoQ. Arquitetura de sistema agêntico mostrando múltiplos agentes especializados colaborando, com componentes de planejamento separados da execução e integração de avaliação em loops de feedback
Modos de Falha Específicos de Sistemas Agênticos
Sistemas agênticos introduzem modos de falha novos que diferem significativamente de arquiteturas tradicionais.
Degradação cascata de decisões: Em pipelines tradicionais, falhas propagam através de dependências explícitas. Em sistemas agênticos, decisões iniciais incorretas influenciam sutilmente raciocínio downstream, amplificando degradação de qualidade de saída. Se um sistema seleciona fontes de candidato subótimas cedo na execução, etapas subsequentes de ranking e avaliação operam sobre inputs de qualidade reduzida, amplificando erro inicial. Padrão particularmente relevante em sistemas de busca e recomendação de larga escala, onde geração de candidatos em estágio inicial influencia significativamente qualidade de ranking downstream.
Amplificação de retry: Sistemas agênticos frequentemente incluem mecanismos para avaliar qualidade de saída e retentar quando resultados são insuficientes. Enquanto melhora adaptabilidade, pode levar a ciclos de iteração excessivos. Diferente de mecanismos de retry tradicionais ligados a erros explícitos, estes retries impulsionam-se por julgamentos de qualidade subjetivos, tornando-os mais difíceis de limitar e controlar. Sem restrições apropriadas, retries impulsionados por avaliação podem aumentar latência, amplificar carga backend e criar padrões de execução imprevisíveis.
Degradação de qualidade silenciosa: Performance pode degradar sem disparar alertas operacionais tradicionais. Métricas de infraestrutura como latência e taxa de erro podem permanecer estáveis enquanto qualidade voltada ao usuário deteriora devido a mudanças em comportamento de tomada de decisão. Particularmente comum em sistemas dependentes de ranking, personalização ou lógica de recomendação. Pequenas mudanças em seleção de ferramenta, estratégias de raciocínio ou interpretação de contexto podem acumular-se ao longo do tempo, levando a mudanças graduais mas significativas em comportamento de sistema. Detectar esses problemas requer monitoramento ciente de avaliação em vez de observabilidade centrada em infraestrutura.
Sobrecarga de coordenação e acúmulo de latência: Conforme sistemas distribuem raciocínio entre múltiplos agentes, caminhos de execução tornam-se mais complexos e menos previsíveis. Cada etapa de coordenação adicional introduz variabilidade em latência e aumenta risco de falhas parciais.
State drift e inconsistência de contexto: Quando contexto é atualizado incrementalmente entre agentes ou etapas, inconsistências em propagação de estado podem resultar em decisões contraditórias ou incompletas, análogo a desafios de consistência em sistemas distribuídos mas manifestando-se como drift de raciocínio em vez de inconsistência de dados.
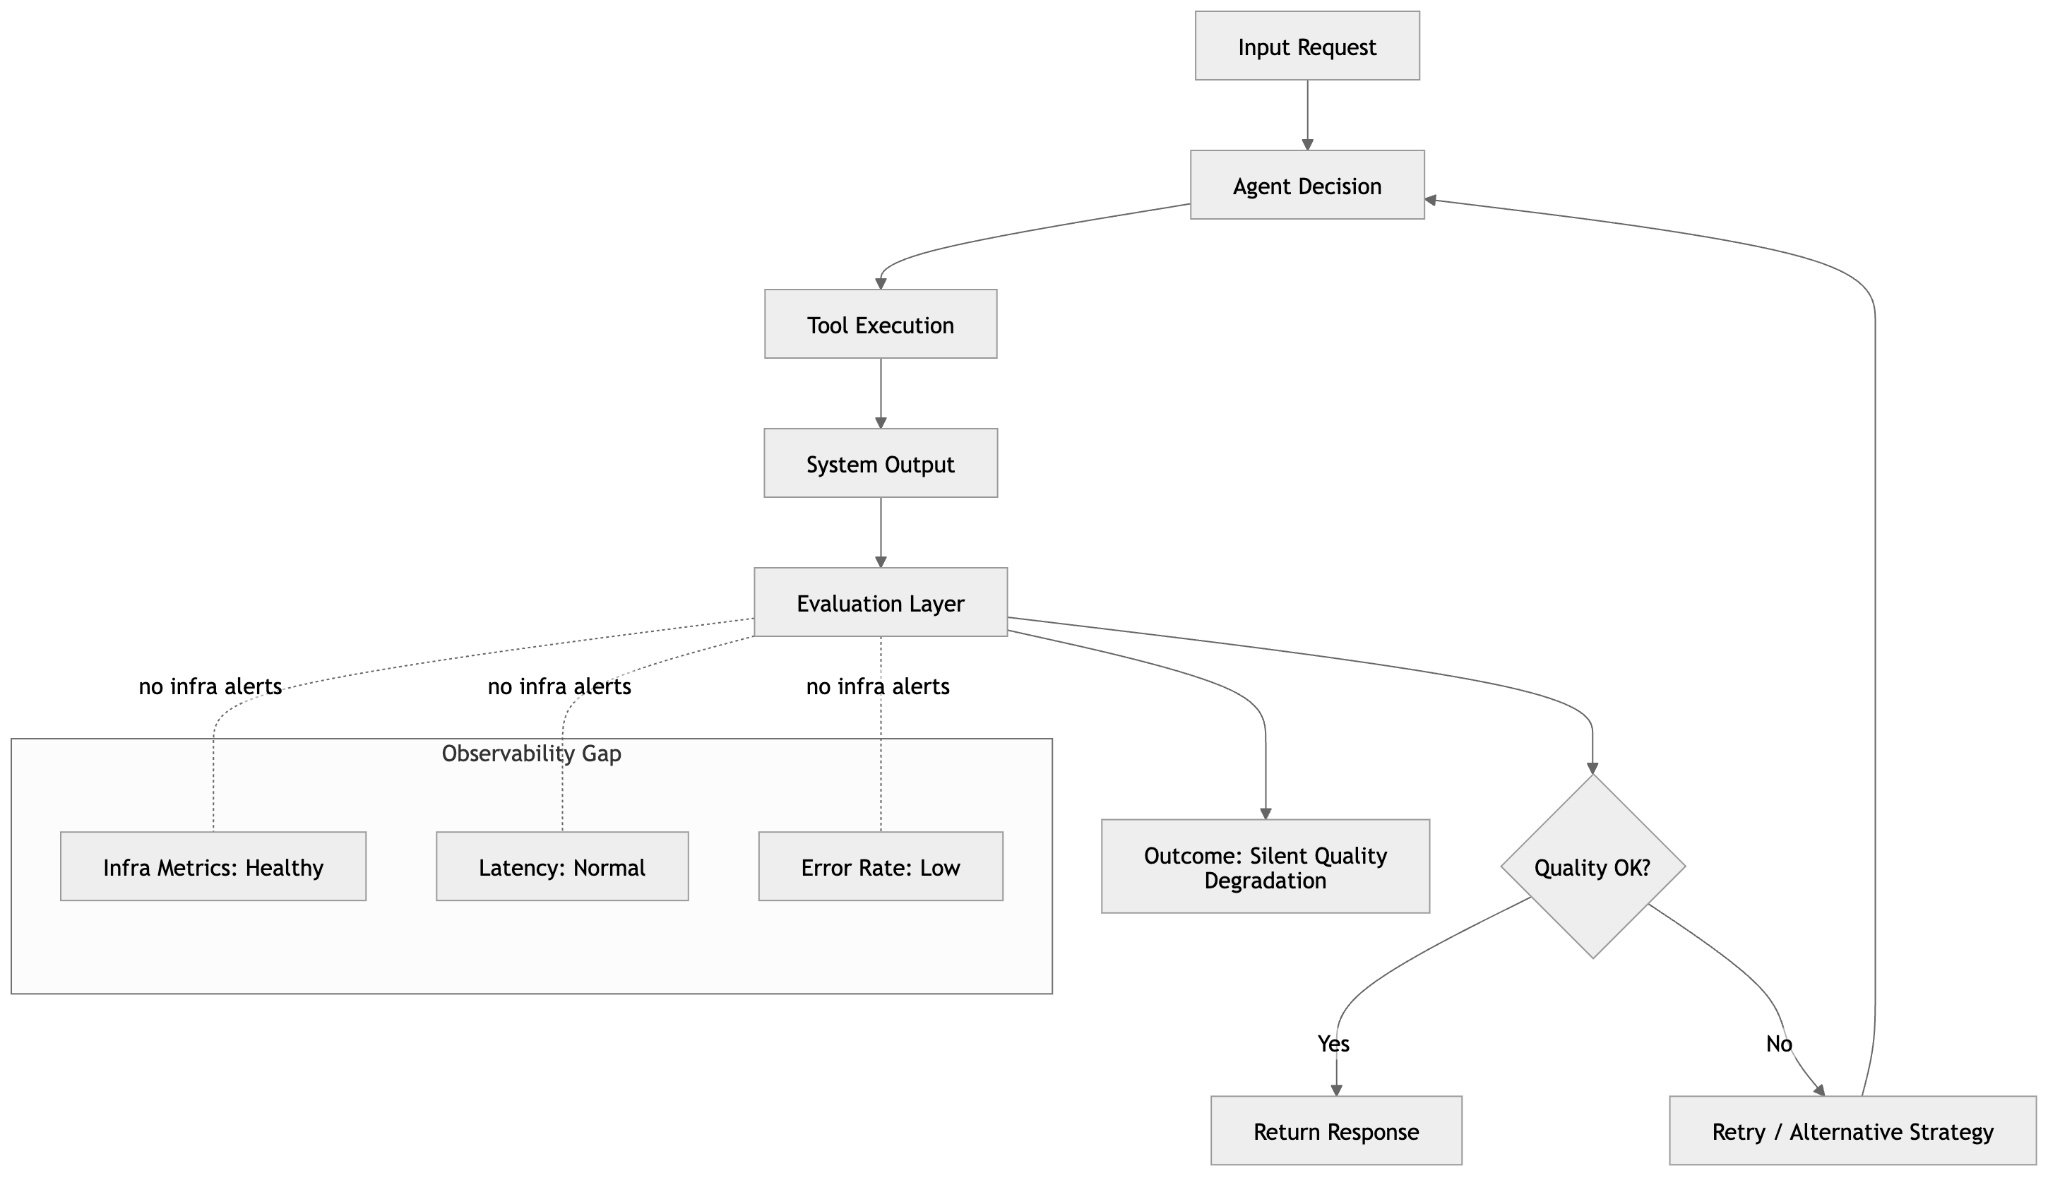
Imagem: InfoQ. Modos de falha silenciosa em sistemas agênticos, demonstrando degradação cascata de decisões onde erros iniciais amplificam-se em etapas downstream e métricas de infraestrutura permanecem estáveis enquanto qualidade degrada
Observabilidade e Confiabilidade Reimaginadas
Modelos tradicionais de observabilidade baseados em métricas como latência, throughput e taxa de erro permanecem necessários mas insuficientes. Dimensão nova é requerida: qualidade de decisão.
Em vez de apenas observar saúde de sistema, equipes devem observar como decisões são feitas. Isso inclui rastrear seleção de ferramentas, etapas de raciocínio, saídas intermediárias e resultados de avaliação. Rastreamento de nível de decisão fornece visibilidade em como comportamento de sistema evolui ao longo do tempo e onde degradação se origina.
Monitoramento de mudanças em comportamento de sistema também torna-se importante. Ao longo do tempo, mudanças em padrões de uso de ferramenta, frequências de seleção de estratégia, taxas de fallback ou comportamento de retry podem indicar que processo de tomada de decisão está derrapando. Aumento súbito em retries ou preferência forte por estratégia única pode sinalizar raciocínio degradado, contexto desatualizado ou sinais de avaliação deficientes. Essas mudanças comportamentais frequentemente emergem antes de métricas voltadas ao usuário como engajamento ou latência. Observar como decisões distribuem-se entre o sistema pode servir como mecanismo de aviso antecipado para detectar degradação de qualidade antes de tornar-se operacionalmente visível.
Infraestrutura de avaliação desempenha papel central em confiabilidade. Em vez de ser tratada como mecanismo de validação offline, avaliação torna-se parte do sistema em tempo de execução, fornecendo loops de feedback que guiam execução e ajudam manter qualidade. Porém, esses loops devem ser cuidadosamente restritos para evitar iteração excessiva ou instabilidade.
Confiabilidade em arquiteturas agênticas também depende de autonomia limitada. Sistemas devem operar dentro de restrições claramente definidas como orçamentos de latência, limites de retry e limites de profundidade de raciocínio. Essas restrições asseguram que flexibilidade não venha ao custo de previsibilidade.
Mecanismos de fallback permanecem essenciais. Caminhos de execução determinísticos fornecem estabilidade quando raciocínio agêntico torna-se incerto ou quando confiança de sistema é baixa. Em muitos sistemas de produção, arquiteturas híbridas combinando tomada de decisão agêntica com pipelines de fallback determinísticos oferecem balanço pragmático entre flexibilidade e confiabilidade.
Estrategias de rollout progressivo são críticas. Capacidades baseadas em IA devem ser introduzidas gradualmente através de experimentação, execução em sombra e implantação controlada. Permite equipes construir confiança em comportamento de sistema enquanto limita exposição a risco.
Confiabilidade em sistemas agênticos requer mudança em mentalidade. Em vez de tratar falhas como eventos binários, sistemas devem ser projetados para degradar graciosamente em qualidade de decisão mantendo experiência de usuário previsível.
Implicações para o Futuro
Arquiteturas agênticas de IA representam evolução natural de sistemas distribuídos. Microsserviços habilitaram decomposição de funcionalidade; sistemas agênticos habilitam decomposição de tomada de decisão.
Esta mudança introduz novas capacidades em adaptabilidade, personalização e execução dinâmica. Também introduz desafios novos em observabilidade, confiabilidade e design de sistema.
Implicação mais importante é que sistemas distribuídos não são apenas sobre orquestração de serviços. Estão cada vez mais sobre orquestração de decisões. Requer estender princípios estabelecidos de engenharia de sistemas distribuídos para camada nova de abstração.
Sucesso dependerá de combinar flexibilidade com disciplina. Os mesmos princípios que habilitaram microsserviços a escalar—limites claros, observabilidade, engenharia de confiabilidade e pensamento de plataforma—serão essenciais neste paradigma novo.