A confiabilidade de sistemas de inteligência artificial agêntica depende não apenas do modelo ou das instruções enviadas a ele, mas também de como a arquitetura escolhe e organiza as informações disponíveis. Em artigo da série “Agentic AI Architecture”, do InfoQ, Adi Polak defende a adoção de um mecanismo de contexto que selecione, filtre, classifique, estruture, comprima, proteja e entregue dados ao modelo antes da inferência.
A proposta parte de uma distinção entre três componentes. Contexto é a informação ativa e temporária usada pelo modelo em uma tarefa, dentro de sua janela de contexto. Memória mantém dados para além de uma interação, dando continuidade entre sessões. Conhecimento reúne fatos, conceitos, regras e informações de domínio que servem como base para o sistema. Para o autor, a arquitetura precisa transformar esses elementos no estado de memória adequado à tarefa e ao momento.
Essa separação é importante porque a mesma informação não é pertinente em todas as situações. O artigo usa como analogia o preparo de uma omelete: saber como sovar massa pode fazer parte do conhecimento disponível, mas não é necessariamente algo que precise ser lembrado durante essa tarefa. Em sistemas agênticos, decidir o que deve estar ativo é responsabilidade da arquitetura que envolve o modelo.
Do prompt ao mecanismo de contexto
Polak chama de context engine o mecanismo que organiza essa camada. Ele integra o plano de controle do contexto e coordena a seleção, a filtragem, a classificação, a estruturação, a compressão, a proteção e a entrega de informações antes que elas cheguem ao ponto de inferência do modelo de linguagem de grande porte (LLM). O mecanismo busca conteúdo no conhecimento, organiza elementos na memória e determina o que deve compor o contexto do agente em cada momento.
A proposta desloca o foco da engenharia de prompts para a engenharia de sistemas. Em vez de se concentrar apenas em formular uma instrução melhor, a equipe precisa construir um processo dinâmico que monte o estado apropriado para o raciocínio. A pergunta central passa a ser qual é o conjunto mínimo de informações de maior valor necessário para o modelo raciocinar bem naquela situação.
O artigo compara o mecanismo de contexto a um compilador. Assim como um compilador converte código-fonte em instruções executáveis, esse mecanismo deve transformar dados brutos, desconectados, históricos e em tempo real em um estado estruturado para raciocínio. A arquitetura descrita autentica e valida entradas conforme as regras de negócio, remove informações pessoais identificáveis (PII) e as isola em um ambiente seguro antes que o LLM produza um plano de ação.
O contexto também deve refletir o domínio e o produto. Uma empresa de tecnologia financeira poderia priorizar horários de transações, anomalias de geolocalização e regras rigorosas de conformidade para um agente de análise de fraude. Já uma empresa de tecnologia jurídica poderia organizar o contexto a partir de leis estaduais para um agente que gera contratos. O artigo ressalta que regras de domínio, limites de segurança e vocabulário variam entre produtos, portanto a arquitetura não deve presumir que uma configuração genérica sirva a todos.
Equilíbrio entre histórico e sinais atuais
Uma arquitetura agêntica precisa combinar informações duradouras com dados recentes. A memória histórica pode incluir interações anteriores, decisões, preferências de usuários, regras de domínio, documentação interna e observações acumuladas. Ela dá continuidade ao agente. As entradas em tempo real, por sua vez, abrangem a tarefa atual, eventos recentes, telemetria, resultados de ferramentas e mudanças no ambiente; são elas que mantêm o sistema ligado à situação presente.
O artigo ilustra essa combinação com um agente DevOps que investiga uma interrupção de servidor. Recuperar um procedimento operacional em um banco vetorial oferece contexto histórico, mas não basta: o agente também precisa dos registros de erro ao vivo dos últimos cinco segundos. A arquitetura deve reunir de modo assíncrono fontes em lote e em fluxo para fornecer uma visão atualizada.
O equilíbrio é essencial. Se o sistema depender demais do histórico, poderá reproduzir pressupostos de ontem diante de uma situação diferente hoje. Se privilegiar excessivamente os dados em tempo real, pode reagir ao sinal mais recente sem conservar a continuidade e o contexto necessários para interpretá-lo. A decisão sobre o que manter, comprimir, revalidar ou excluir precisa considerar que o raciocínio é probabilístico, tem custo e está limitado pela janela de contexto.
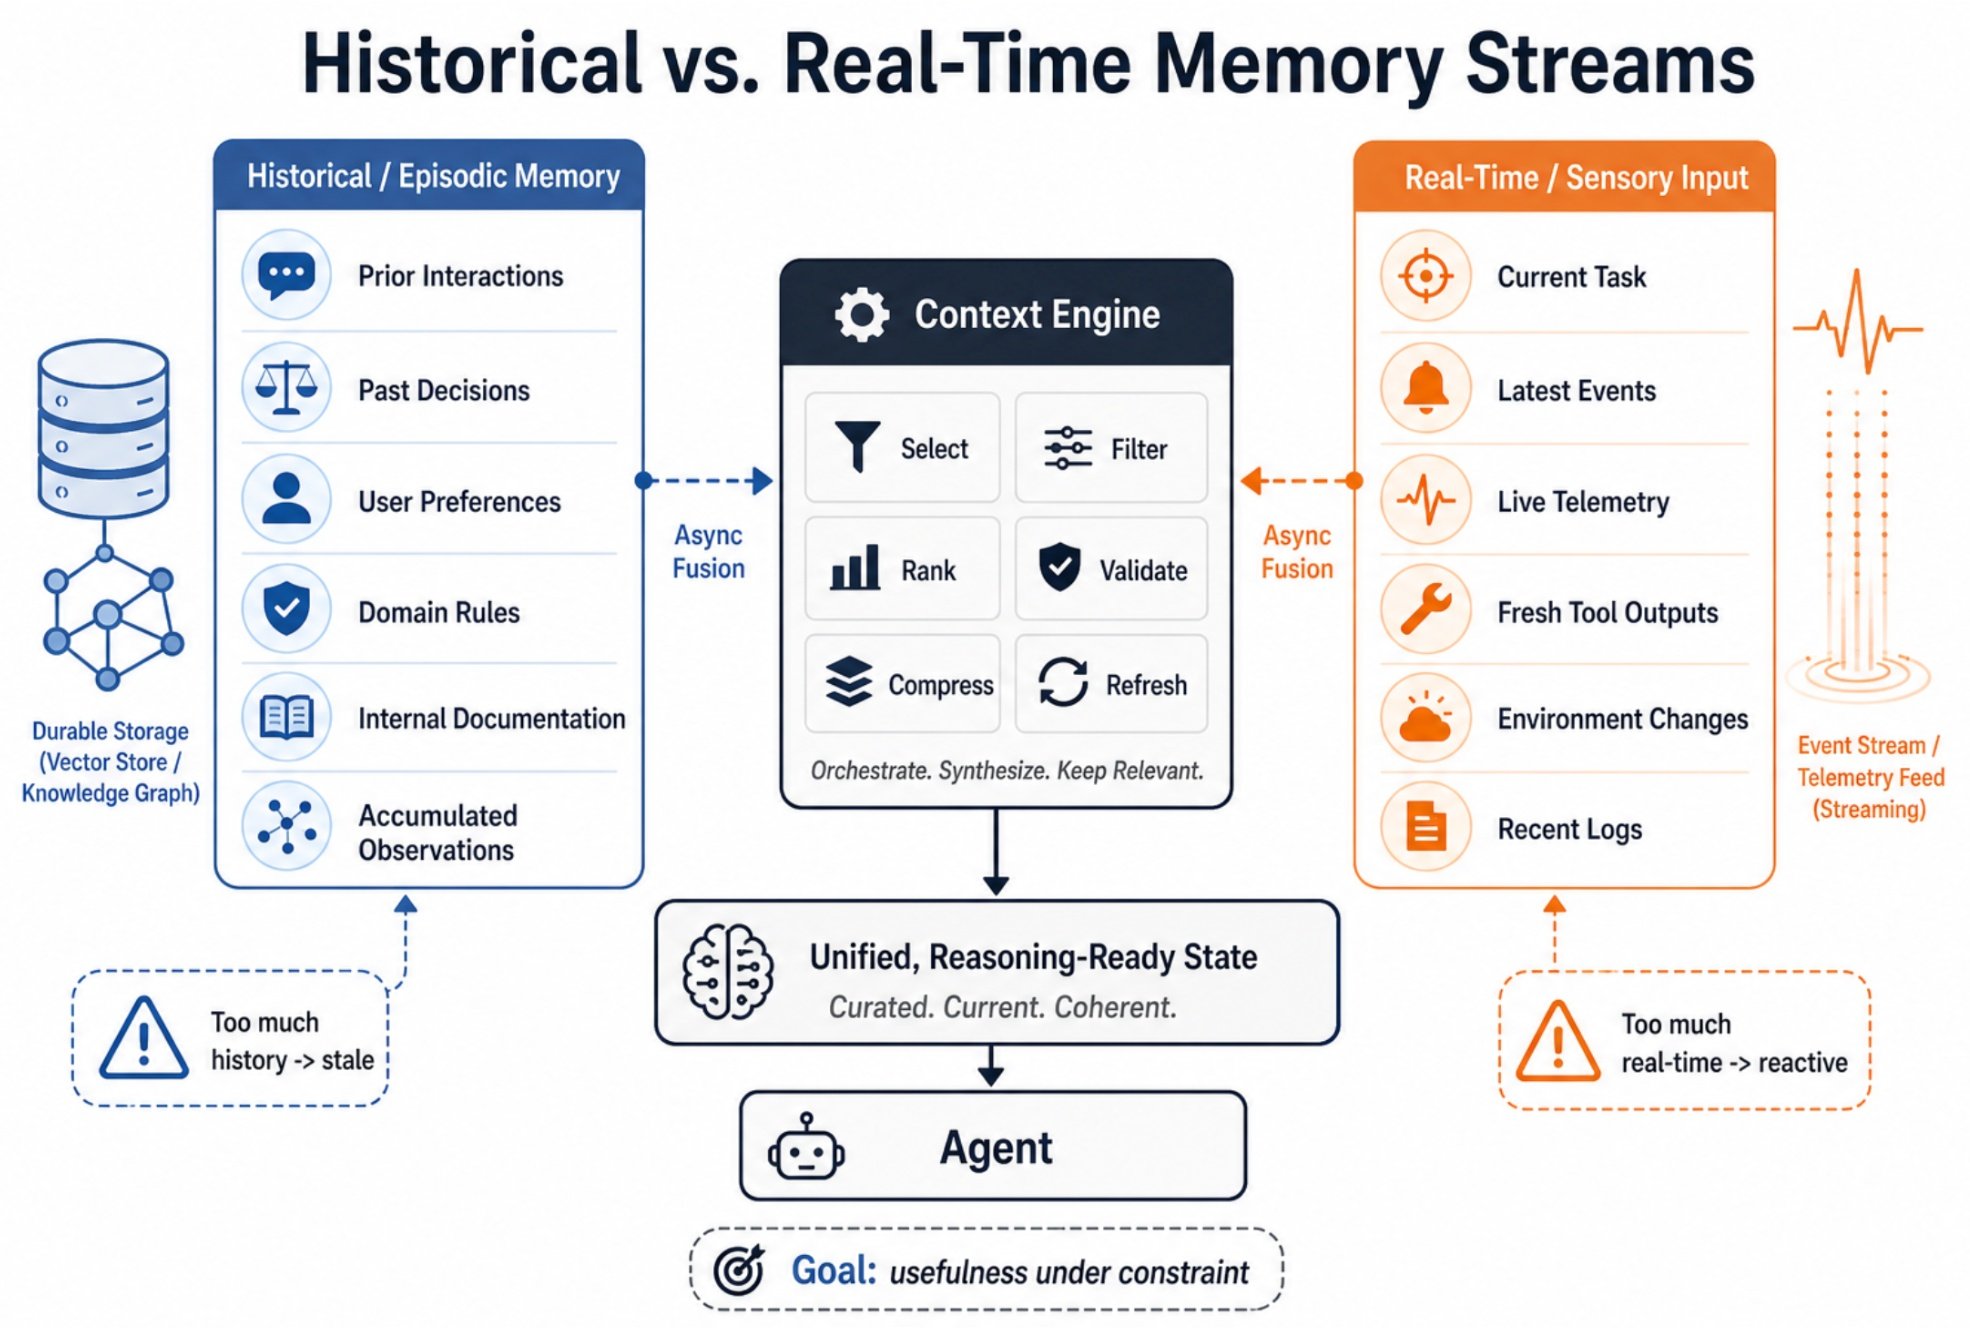
Imagem: InfoQ. Dados históricos versus fluxos de memória em tempo real. Imagem criada pelo autor com Gemini.
Figura 1: Dados históricos versus fluxos de memória em tempo real. Imagem criada pelo autor com Gemini.
Conhecimento organizado, não acúmulo de dados
O artigo critica a ideia de que recuperar mais dados necessariamente melhora uma resposta. Sistemas que despejam grandes volumes de fragmentos brutos, redundantes ou sobrepostos podem aumentar o ruído e dificultar a identificação do que importa. Como exemplo, Polak descreve um fluxo que colocaria dez páginas de uma wiki sem edição dentro do prompt, obrigando o modelo a separar sinais relevantes de informações menos importantes.
A alternativa proposta é curar o conhecimento. Processos em segundo plano, incluindo trabalhadores e fluxos de aprendizado de máquina, podem agregar, resumir e classificar dados conforme sua relevância e o estado atual do sistema. O objetivo é converter dados dispersos em grafos de conhecimento ou resumos condensados. Um exemplo apresentado é processar uma base com um milhão de registros e gerar uma entrada resumida a cada período de 12 horas, em vez de enviar todo o conteúdo ao modelo.
A recuperação continua sendo uma etapa para levar dados ao sistema, mas não garante, por si só, que sejam úteis, atuais, coerentes ou bem classificados para a decisão em questão. Por isso, o artigo recomenda distinguir os dados recuperados do conhecimento preparado para uso, priorizando uma síntese adequada em vez de uma coleção extensa de trechos.
Quatro etapas para administrar o contexto
O ciclo de vida proposto tem quatro etapas: seleção, injeção, compressão e expiração/atualização. Elas podem ser implementadas como módulos da arquitetura ou serviços independentes.
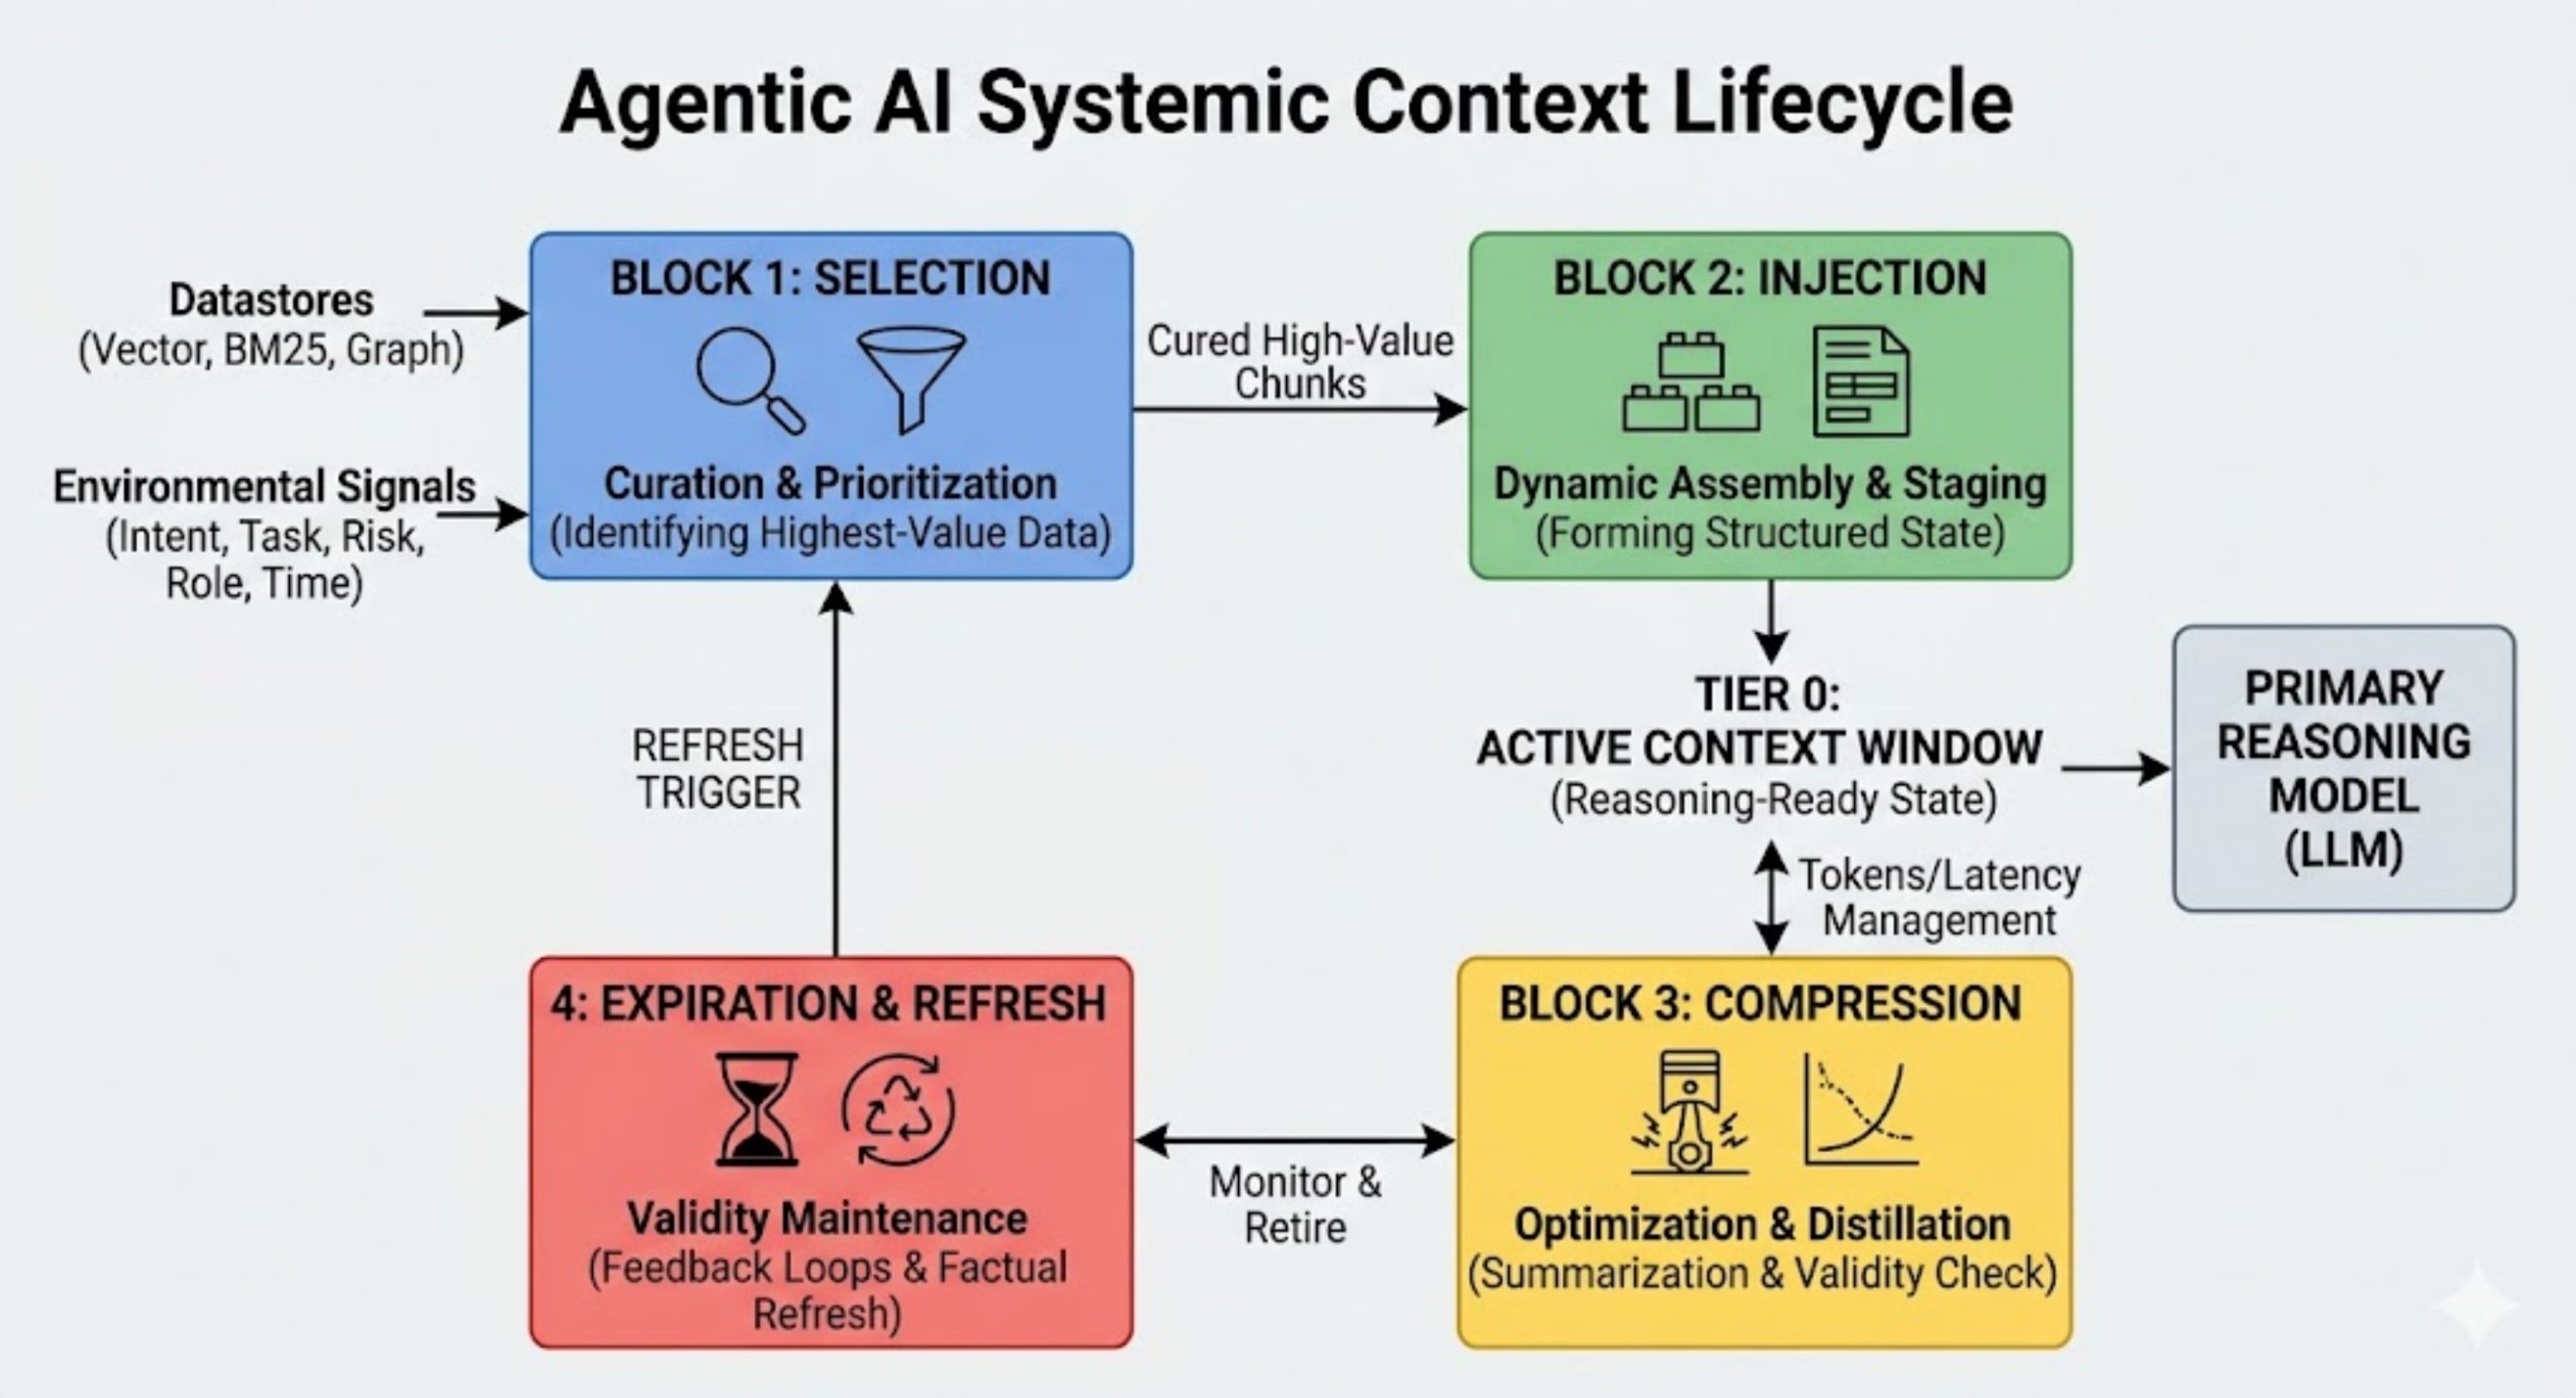
Imagem: InfoQ. Ciclo sistêmico de vida do contexto em IA agêntica. Imagem criada pelo autor com Gemini.
Figura 2: Ciclo sistêmico de vida do contexto em IA agêntica. Imagem criada pelo autor com Gemini.
-
Seleção: identifica os dados de maior valor para a tarefa, considerando intenção, tipo de atividade, risco, papel do usuário e relevância temporal. O texto cita busca híbrida, que combina busca semântica densa, busca esparsa por palavras-chave — como BM25 — e travessia de grafos de conhecimento. A mesma coleção de dados pode produzir contextos distintos para agentes de suporte, pesquisa ou solução de problemas.
-
Injeção: posiciona as informações selecionadas na janela de contexto do modelo em uma forma apropriada. Isso inclui organizar os dados conforme a intenção explícita do usuário, além de adicionar, quando necessário, instruções de sistema, exemplos few-shot e restrições de saída, como definições em JSON. Ordem, agrupamento e estrutura podem influenciar o raciocínio do modelo.
-
Compressão: reduz o volume de históricos e documentos para controlar limites de tokens, custos e latência. O artigo sugere usar modelos menores e mais rápidos ou algoritmos determinísticos para resumir conversas e condensar documentos, com testes para identificar distorções. Entre as medidas mencionadas para avaliar resumos estão a razão de perplexidade (PPL), a divergência de Kullback–Leibler (KL) em nível de token e o teste qui-quadrado para saídas categóricas.
-
Expiração e atualização: remove pressupostos que deixaram de ser válidos e renova fatos que mudam. Uma preferência pode permanecer estável por meses ou mudar de um dia para o outro; uma configuração de produto pode mudar em minutos; e um incidente de suporte pode ser relevante por um dia, mas induzir a erro uma semana depois. Sem mecanismos de expiração e atualização, o sistema pode entrar em ciclos de dados obsoletos. O artigo recomenda validar continuamente o sistema por ciclos de feedback, de acordo com o objetivo do produto. Em um serviço de compartilhamento de carros, por exemplo, uma queda súbita na satisfação dos usuários poderia motivar a investigação de fatores que precisam ser atualizados.
Alucinações, janelas de contexto e custo
O autor associa muitas alucinações a falhas na gestão do contexto, e não necessariamente a um modelo defeituoso. Quando falta informação factual explícita para responder ou executar uma tarefa, o modelo pode preencher lacunas com associações aprendidas durante o treinamento. Como defesa, o artigo recomenda fornecer conhecimento relevante e de alta confiança e instruir o sistema a raciocinar com base no contexto fornecido.
Essa gestão também tem implicações econômicas. Cada token enviado ao modelo consome recursos de processamento, pode aumentar a latência e afeta o custo da API. O texto observa que a expansão das janelas — de 128 mil a mais de 1 milhão de tokens em alguns modelos — pode estimular a inclusão indiscriminada de repositórios de código ou grandes coleções de documentos. Essa prática tende a elevar o tempo até o primeiro token (TTFT) e os custos e, segundo o artigo, também pode prejudicar a qualidade das respostas.
Um dos motivos citados é o fenômeno “Lost in the Middle” (“perdido no meio”), associado a uma pesquisa de Nelson F. Liu e colegas de Stanford, publicada em 2023. Segundo a descrição do artigo, modelos podem ter mais dificuldade para recuperar fatos colocados no centro de contextos muito extensos, em comparação com informações em outras posições. Assim, aumentar a janela não elimina a necessidade de escolher o que enviar.
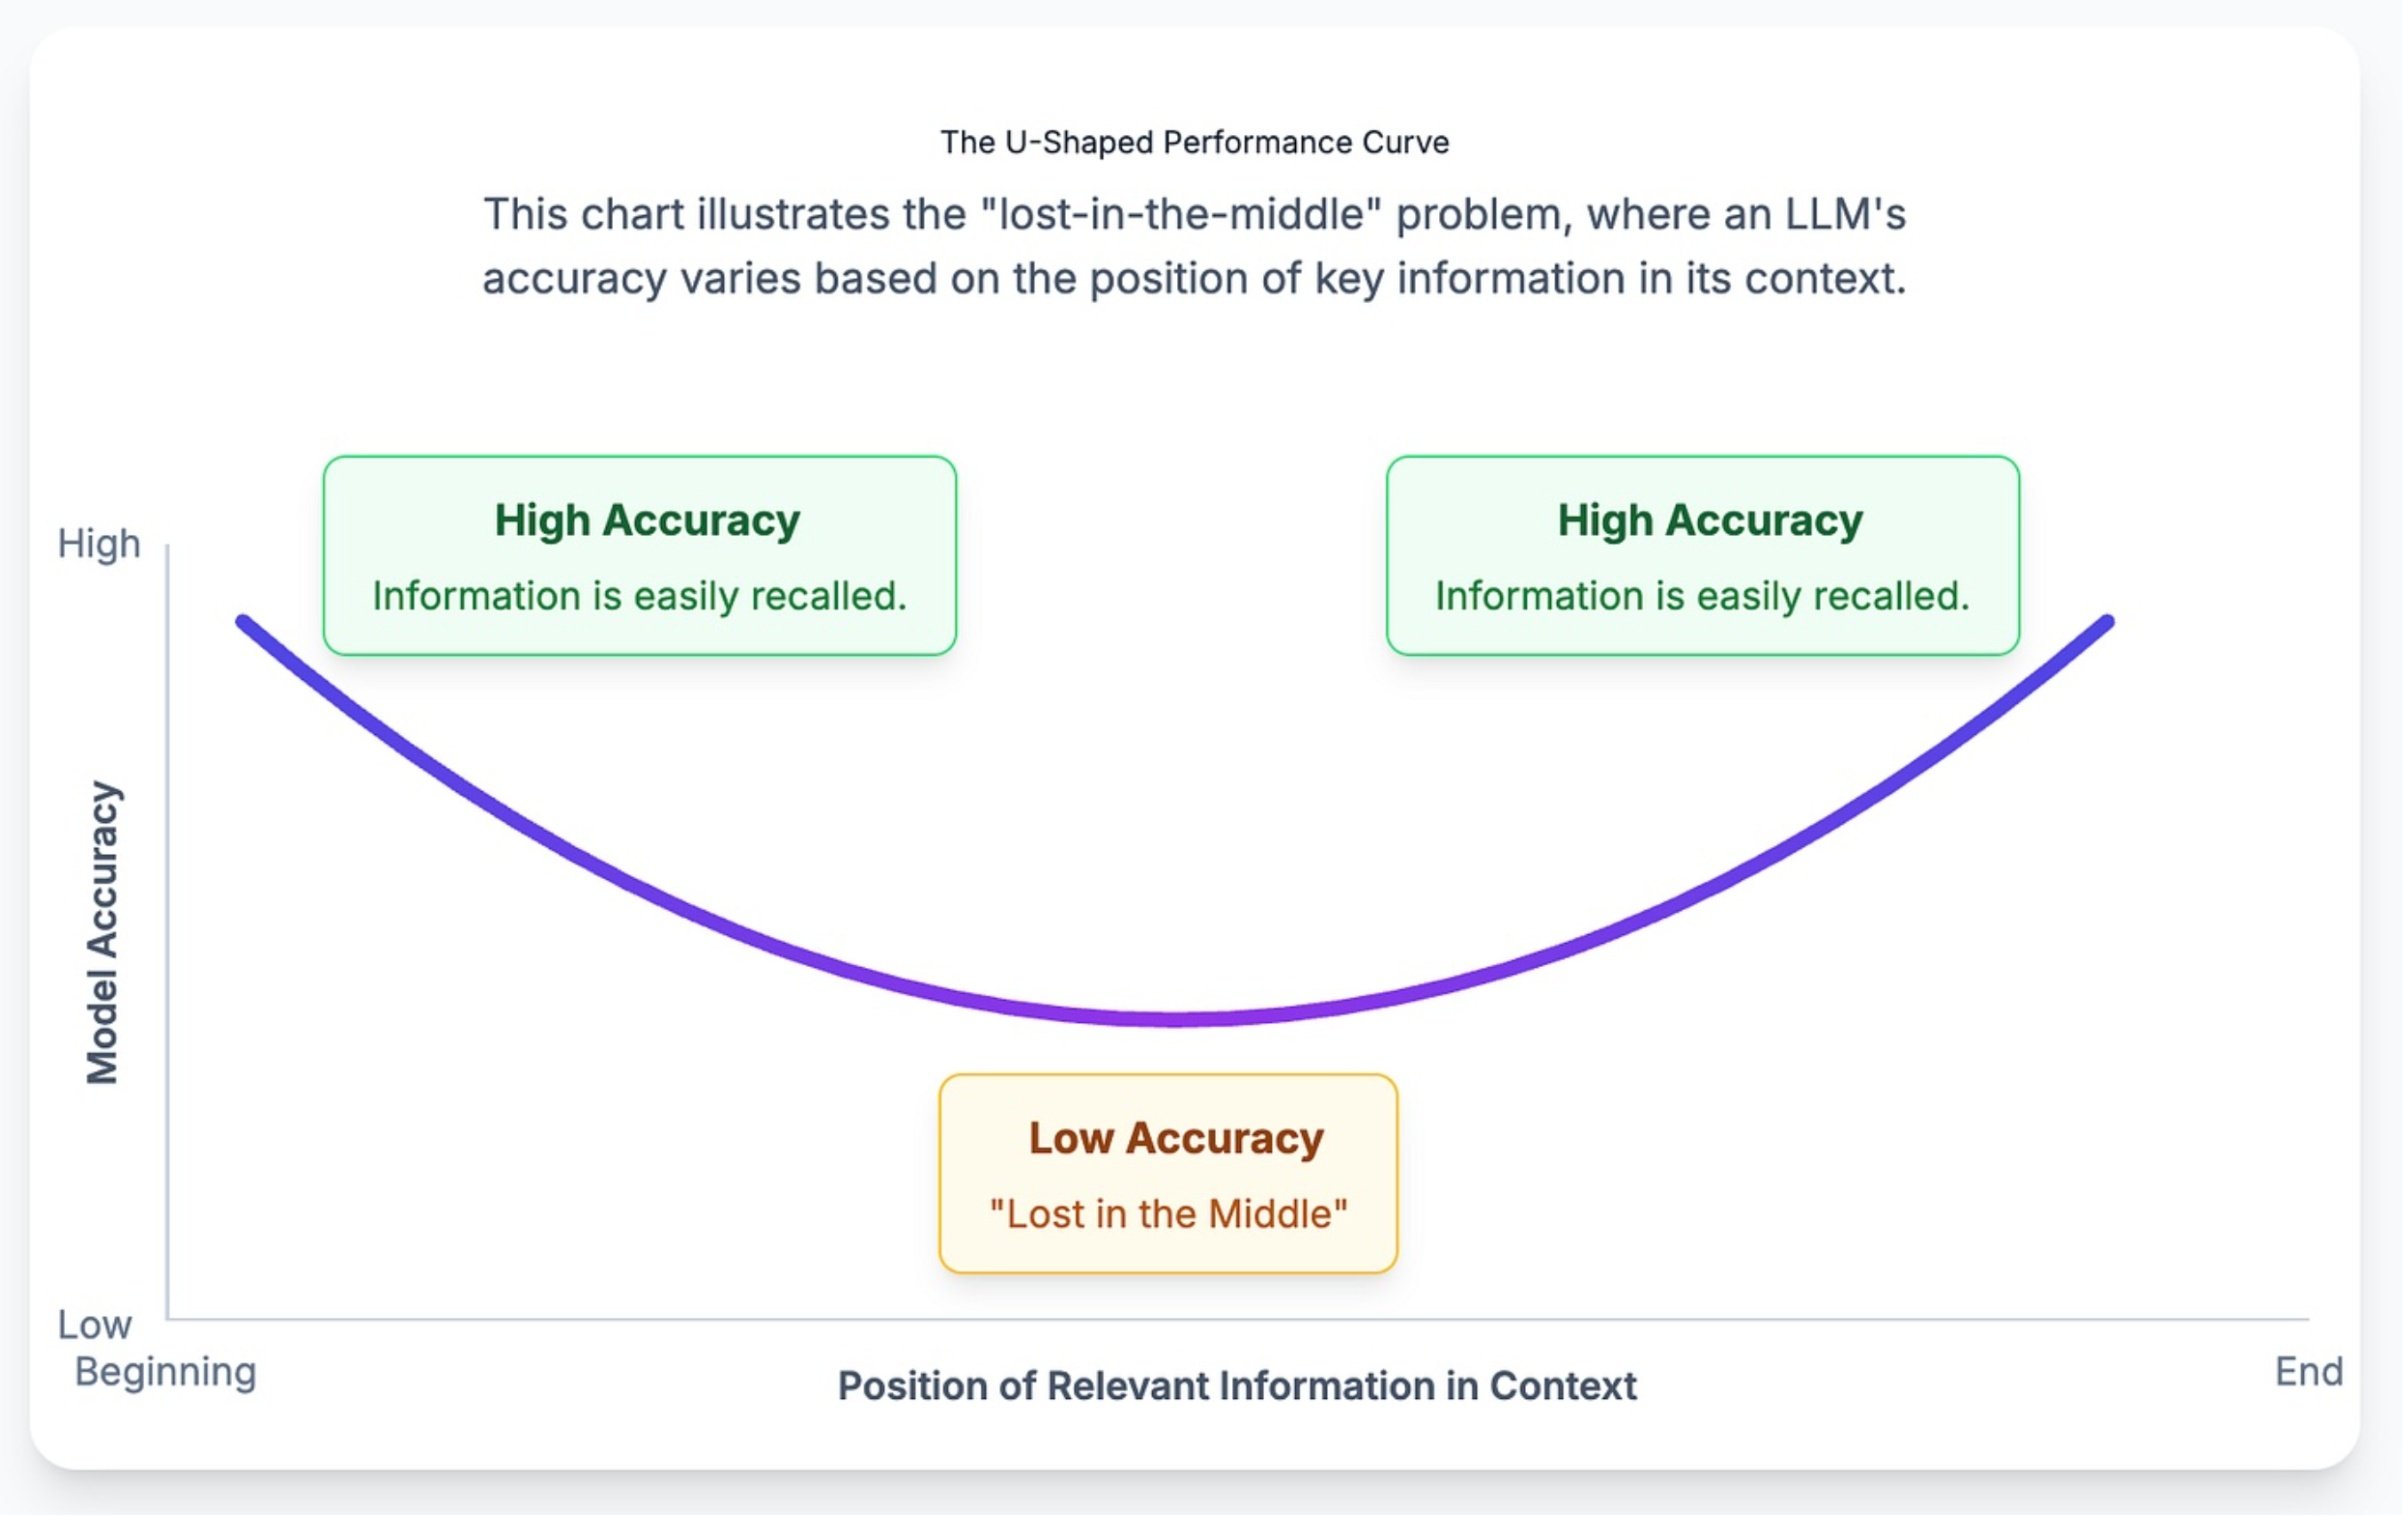
Imagem: InfoQ. Problema “perdido no meio”: recuperação versus precisão, com base em artigo científico de Stanford. Imagem criada pelo autor com Gemini.
Figura 3: Problema “perdido no meio”: recuperação versus precisão, com base em artigo científico de Stanford. Imagem criada pelo autor com Gemini.
Para equilibrar custo e desempenho, Polak recomenda estabelecer um orçamento de contexto, podar informações de forma iterativa e usar mecanismos de cache. A equipe deve comparar o valor esperado de cada documento recuperado com sua relevância e seu custo em tokens, em vez de enviar grandes quantidades de conteúdo apenas porque a janela permite.
Memória em camadas e falhas recorrentes
A arquitetura de memória sugerida tem três níveis. A memória de trabalho corresponde ao estado temporário necessário para a etapa atual, mantido na janela do prompt e reiniciado a cada chamada de inferência. A memória de curto prazo preserva o estado da conversa, etapas intermediárias e ações recentes por minutos ou horas; o artigo cita o Redis como exemplo de armazenamento em memória para esse uso. A memória de longo prazo guarda conhecimentos sintetizados, preferências e fatos históricos. Bancos vetoriais e grafos de conhecimento podem sustentar essa persistência, com atualizações assíncronas para que o acúmulo não sobrecarregue a recuperação em tempo real.
O texto identifica cinco antipadrões e associa a cada um medidas de mitigação:
- Excesso de contexto: inserir todos os documentos, registros e resultados de ferramentas que pareçam plausíveis aumenta o ruído, dilui a atenção, eleva a latência e reduz a precisão. O artigo propõe limites de relevância e recomenda excluir documentos abaixo de um limiar de confiança, em vez de incluí-los indiscriminadamente.
- Ciclos de dados obsoletos: reutilizar informações históricas sem verificar se continuam corretas pode levar o agente a agir com confiança sobre uma realidade ultrapassada. Filtros por metadados e timestamps ajudam a conferir a atualidade; arquiteturas orientadas a eventos, como Kafka, podem invalidar proativamente embeddings desatualizados.
- Recuperação genérica: aplicar o mesmo fluxo de recuperação para agentes com tarefas diferentes pode ignorar regras de domínio e trazer trechos irrelevantes. Uma medida sugerida é reescrever consultas com um modelo menor, adaptando a pergunta do usuário a vetores de busca específicos do domínio.
- Desalinhamento entre memória implícita e pedido explícito: informações mantidas sobre o usuário podem não combinar com o que ele está pedindo agora, fazendo a resposta parecer deslocada ou excessivamente familiar. O artigo recomenda separar, em um modelo de prompt estruturado, o contexto do sistema, o contexto do usuário e a instrução da tarefa atual.
- Crescimento ilimitado da memória: guardar todos os registros, conversas e ações sem poda pode transformar retenção em acúmulo indiscriminado. A recomendação é aplicar políticas de tempo de vida (TTL) por categoria. Dados em tempo real, como telemetria de latência de API e cliques na interface, devem expirar em minutos ou horas; dados de tarefa e sessão, ao fim da sessão ou da meta; e conhecimento central, como preferências e fatos verificados, pode persistir indefinidamente, mas precisa de revalidação periódica.
Na conclusão, Polak argumenta que o desempenho de sistemas agênticos dependerá principalmente das decisões de arquitetura. Entre os desafios destacados estão o gerenciamento de estado, a priorização de sinais, o isolamento de falhas, a atualização dos dados, a segurança e o controle de custos. O artigo integra a série “Agentic AI Architecture” do InfoQ e apresenta a gestão de contexto, memória e conhecimento como partes centrais da infraestrutura necessária para agentes autônomos.