TypeSafe AI, um laboratório de IA sediado em San Francisco e fundado pelo ex-pesquisador da OpenAI Diogo Almeida, lançou Jev, o primeiro modelo da série que chama de System One Models. Diferentemente dos modelos generativos convencionais, Jev não produz texto — ele retorna decisões tipadas com probabilidades que o software pode usar diretamente.
Como funciona
O funcionamento é simples: você envia um estado (string ou dados estruturados) junto com um conjunto de perguntas tipadas. Jev avalia todas elas em uma única passada paralela e retorna respostas com Choice, Score e Noul, acompanhadas de distribuição de probabilidade e valor de confiança. Assim, o código que o chama pode agir quando a confiança ultrapassa um limiar e escalar quando fica abaixo.
Os custos são competitivos: entrada a $0,042 por milhão de tokens, saída gratuita. A janela de contexto comporta 32 mil tokens, e a latência de ponta a ponta fica entre 70ms e 500ms. O treinamento usa um método chamado Reinforcement Learning for Calibrated Decisions.
Adoção acelerada
A chegada ao mercado foi meteórica. Vercel integrou Jev ao AI Gateway no segundo dia de lançamento e alcançou quase 13% dos times pagos em apenas 24 horas — o dobro da participação da família GPT-5.6 no mesmo período. Netlify seguiu rápido. LangChain entregou uma integração TypeSafeClassifier com roteamento de modelos e um middleware AutoMode que valida chamadas de ferramentas antes de executá-las. Cinco clientes independentes de Elixir surgiram em dias.
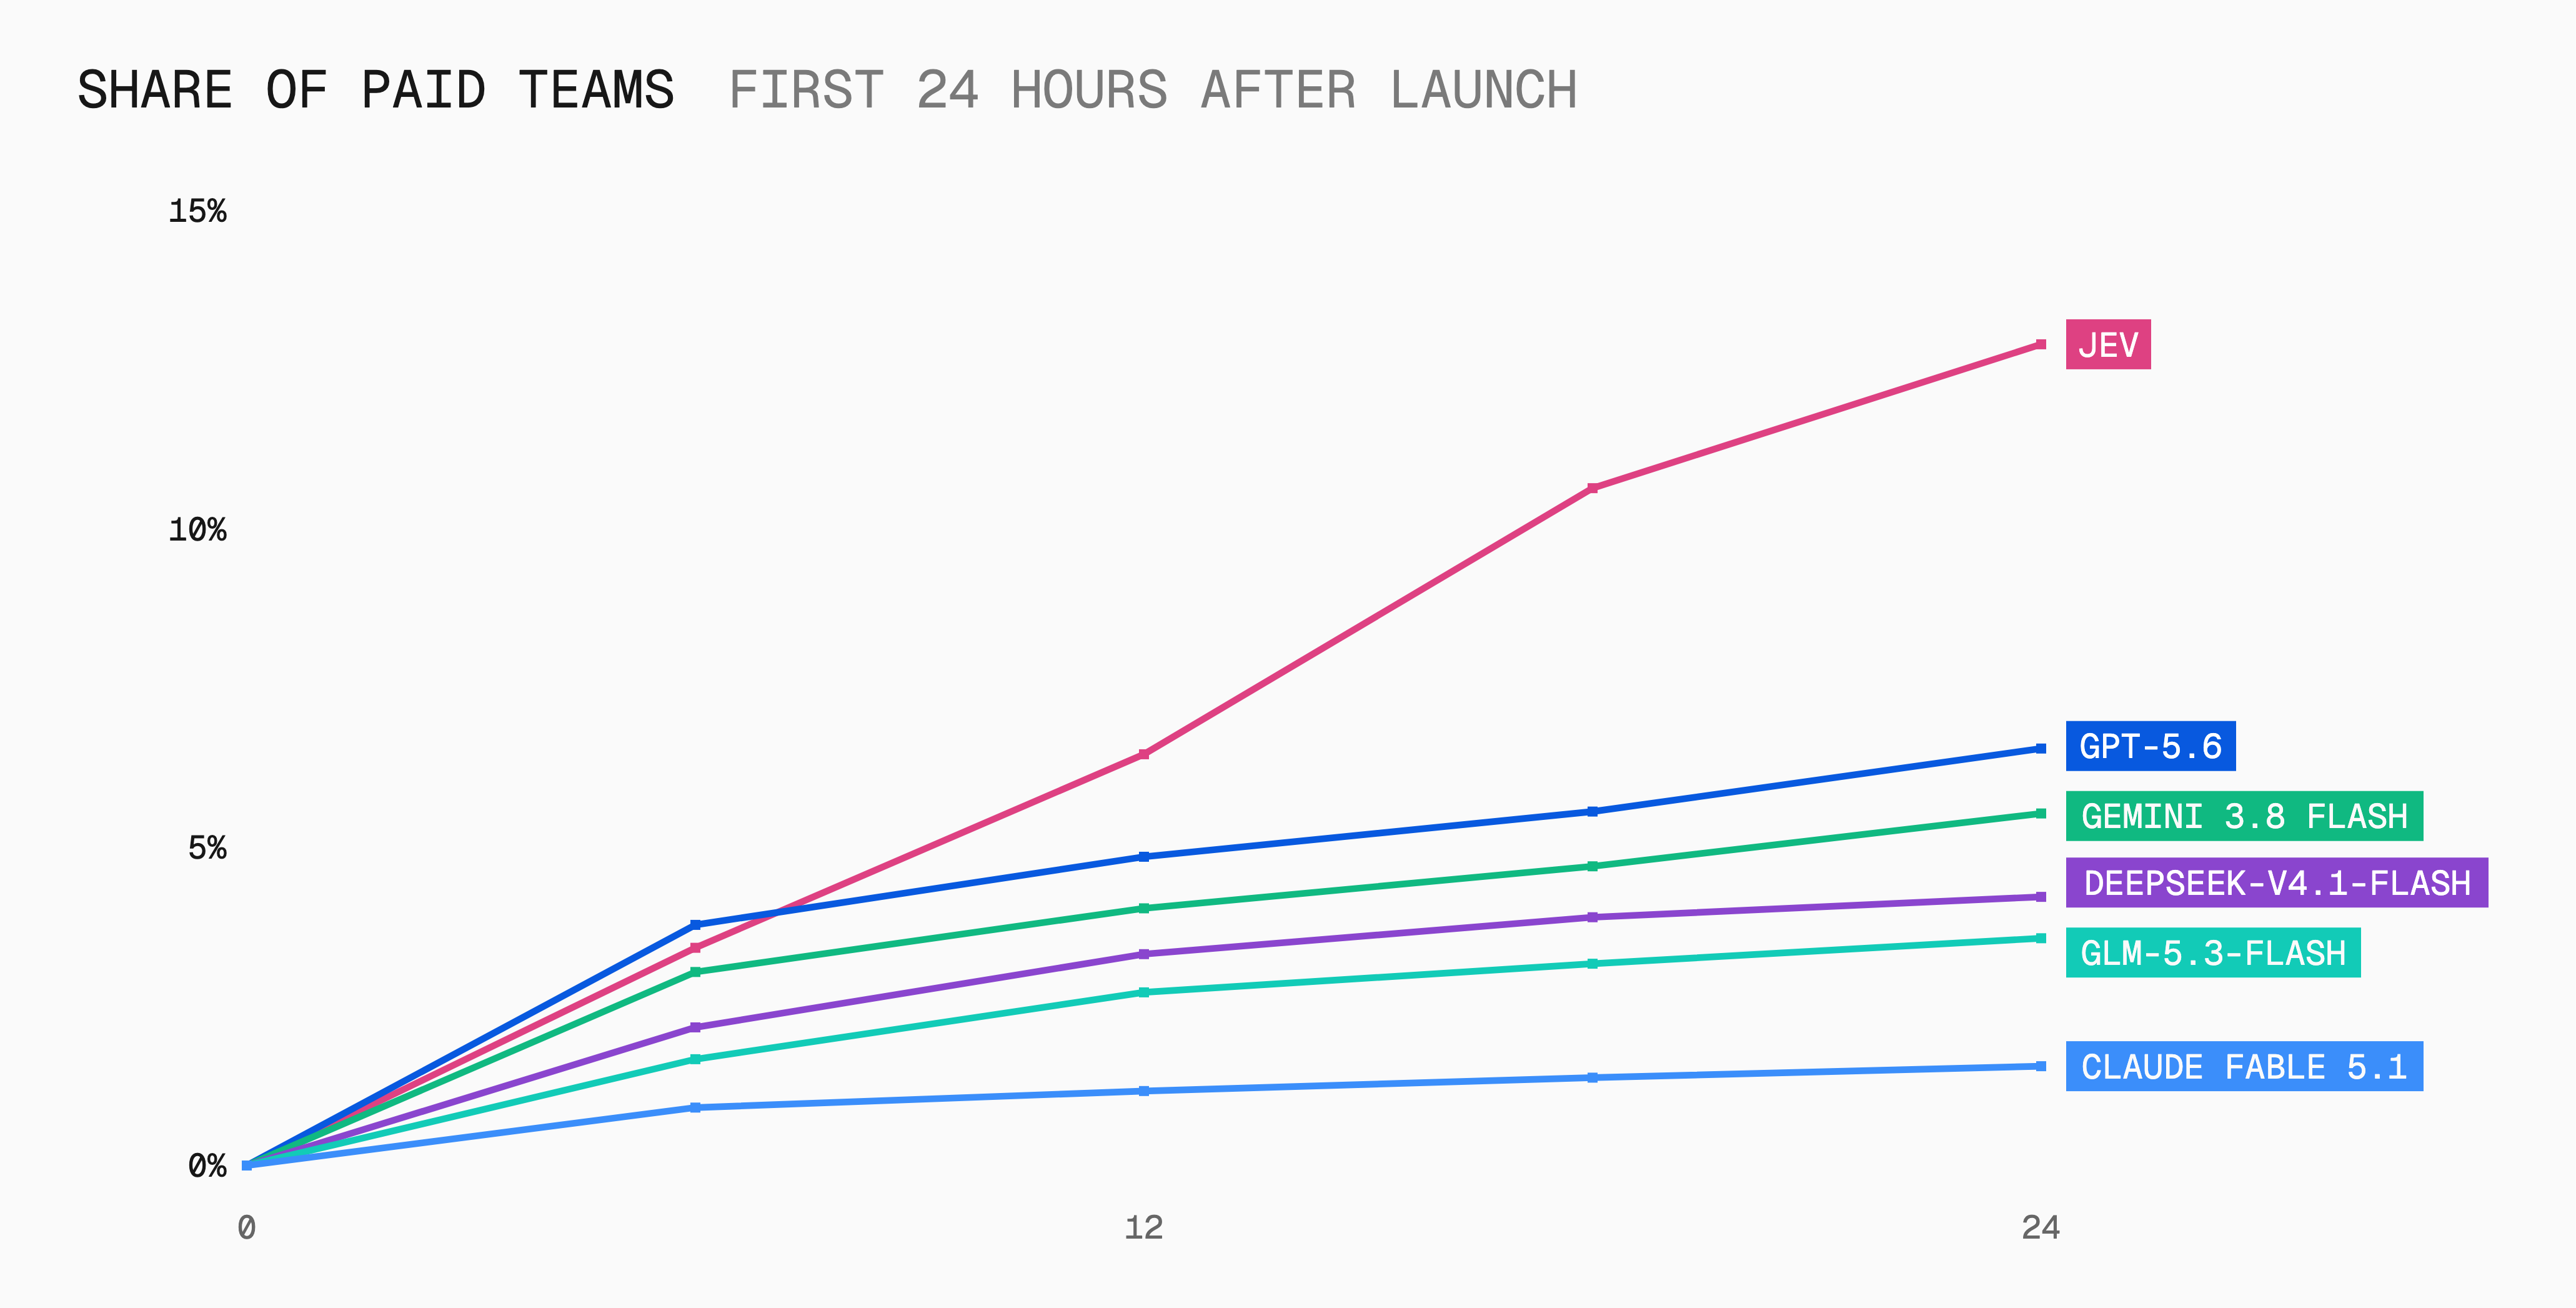
Adoção de Jev no Vercel AI Gateway no primeiro dia comparada com outros lançamentos recentes. Crédito: Vercel. Imagem: InfoQ
Casos de uso e desempenho
Os números de desempenho impressionam. Um engenheiro da Vercel, Pranit Sharma, relata que um classificador de segurança rodando com Jev executou cinco a 18 vezes mais rápido que o LLM que substituiu. Nikhil Mudholkar, CTO da Bryo AI, avaliou o Gemini como ligeiramente mais preciso em classificação de e-mails, mas 10 a 20 vezes mais caro — e valorizou Jev como o único que entrega uma probabilidade real. Armin Ronacher, CTO da Earendil, disse a TechCrunch que o design "delegua o problema de alucinações um pouco para o usuário", que precisa decidir se uma probabilidade de 50% justifica agir.
Uma análise de 12.759 tweets de lançamento pela OpenChamber mostrou acelerações medianas reportadas pelos usuários em 7x (contra o destaque de 193,6x), economia de custos na mediana de 30x, e latência mediana de 76ms com quartil superior de 270ms.
No Reddit, um desenvolvedor chamou o modelo de "absolutamente insano" para trabalhos com agentes, em latência de 200ms a 300ms. No Hacker News, um usuário em early access o descreveu como "realmente interessante", mas alertou que o comportamento fora da distribuição diferirá de um LLM.