A Netflix está construindo uma plataforma para aumentar a confiabilidade de cargas de treinamento e inferência de inteligência artificial em GPUs. A arquitetura combina verificações de hardware, resposta automática a falhas e recuperação de trabalhos longos. A empresa relata disponibilidade de nós de GPU superior a 99,95% e aumento na taxa de sucesso dos trabalhos de cerca de 98% para mais de 99,5%.
O desafio cresce em treinamentos que podem durar semanas e ocupar centenas de GPUs, cujos workers precisam avançar em conjunto. Uma GPU defeituosa, um adaptador de rede degradado ou uma máquina lenta pode interromper ou reduzir o desempenho de toda a carga. Por isso, a plataforma de computação da Netflix, construída sobre Kubernetes, procura detectar problemas, retirar capacidade não saudável e permitir que trabalhos em andamento se recuperem da perda de máquinas.
A empresa observa que uma verificação convencional de nuvem — confirmar que uma máquina virtual está ativa e acessível — não demonstra que as GPUs conseguem sustentar uma tarefa distribuída. Uma GPU pode responder normalmente a uma consulta de status e falhar quando recebe uma alocação de memória ou inicia computação prolongada. Da mesma forma, um adaptador de rede pode estar presente, mas operar com menos conexões do que o esperado, reduzindo drasticamente a largura de banda de operações coletivas.
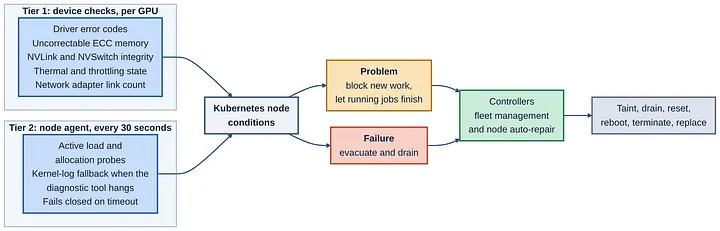
Imagem: InfoQ. Verificações de GPU e rede alimentam as condições de saúde dos nós usadas pelos controladores.
Para avaliar os dispositivos, a Netflix usa NVIDIA DCGM, que monitora erros de GPU, memória, interconexão e condições térmicas. As verificações de rede examinam o estado e a quantidade de interfaces de alta velocidade Elastic Fabric Adapter. Um agente de nó do Kubernetes transforma os resultados em condições que podem ser usadas pelos controladores.
As verificações foram projetadas para falhar de forma segura: se uma ferramenta de diagnóstico trava, o tempo limite marca a máquina como não saudável, em vez de permitir que a verificação defeituosa indique sucesso. A Netflix também mantém uma alternativa baseada em logs do kernel para situações em que o mecanismo habitual de diagnóstico de GPU falha.
Identificar um problema é apenas uma etapa. Os controladores da plataforma respondem de maneira progressiva, sem substituir imediatamente uma máquina inteira. Diante de uma falha transitória, podem bloquear a entrada de novos trabalhos e deixar as cargas atuais seguirem. Se a condição persistir, a máquina é drenada e as cargas são movidas. Conforme o problema, a correção pode consistir em encerrar um trabalho específico, reiniciar uma GPU, reiniciar a máquina ou substituí-la.
Essa resposta se integra aos recursos de reparo automático de nós do Karpenter. A Netflix acrescenta políticas para definir quanto tempo tolerar cada tipo de falha e qual parcela do cluster pode ser afetada de uma vez.
Como falhas de hardware não podem ser eliminadas, a plataforma também busca reduzir o custo da recuperação. Trabalhos grandes usam checkpoints e workers elásticos: quando uma máquina se perde, o treinamento pode retomar do último checkpoint saudável. A plataforma pode tentar novamente trabalhos com falhas, mas separa falhas de aplicação para evitar reinícios repetidos quando a causa é um bug de software.
A Netflix também analisa o trabalho de treinamento como um sistema distribuído, não apenas como um conjunto de máquinas. A plataforma pode identificar uma única rank lenta que atrasa o restante da execução. Em cargas síncronas, portanto, uma GPU não precisa falhar para reduzir o rendimento do trabalho.
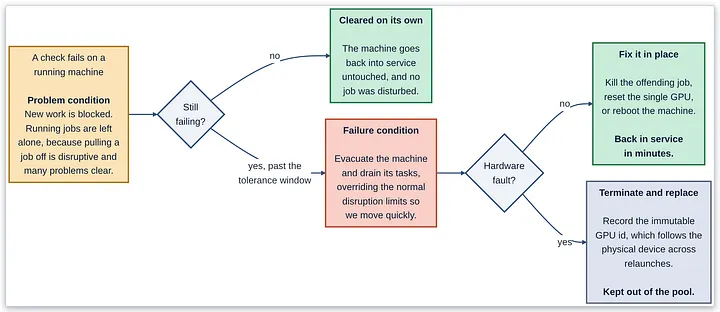
Imagem: InfoQ. A Netflix combina recuperação de treinamentos distribuídos com compartilhamento de GPUs para cargas menores de inferência.
Para cargas menores de inferência, a Netflix usa os recursos Multi-Instance GPU (MIG), da NVIDIA, que permitem compartilhar GPUs mantendo isolamento de memória entre tenants. Segundo a matéria, isso melhora a utilização em comparação com reservar uma GPU inteira para cada carga.
A empresa também trabalha para adotar Kubernetes Dynamic Resource Allocation (DRA). A mudança deverá permitir solicitações de recursos mais expressivas e posicionamento atento à topologia, levando em conta onde GPUs, adaptadores de rede e CPUs ficam na máquina. Trata-se de uma iniciativa em andamento, não de um recurso descrito como já implantado.
A matéria compara a abordagem com a da Meta, que também utiliza diagnósticos de hardware, remediação automática, checkpoints e recuperação rápida. O trabalho recente da Meta dá atenção especial à detecção de falhas de hardware, inclusive corrupção silenciosa de dados (SDCs), em clusters de grande escala. A empresa relata que falhas de hardware representaram mais de 66% das interrupções de treinamento em sua experiência com o Llama 3.
As duas estratégias compartilham o uso de diagnósticos, correção e recuperação, mas enfatizam aspectos diferentes. A arquitetura da Netflix fecha o ciclo operacional: valida o hardware antes do agendamento, monitora-o durante a execução, identifica o domínio da falha, aplica correções automáticas e mede o goodput. A Meta, por sua vez, investiu fortemente em detecção de falhas no hardware e manutenção de clusters, além da recuperação.
A escala altera o próprio critério de confiabilidade. Em clusters com milhares de GPUs, manter máquinas individuais disponíveis não basta: é necessário detectar falhas, limitar seus efeitos e preservar a continuidade dos trabalhos distribuídos.