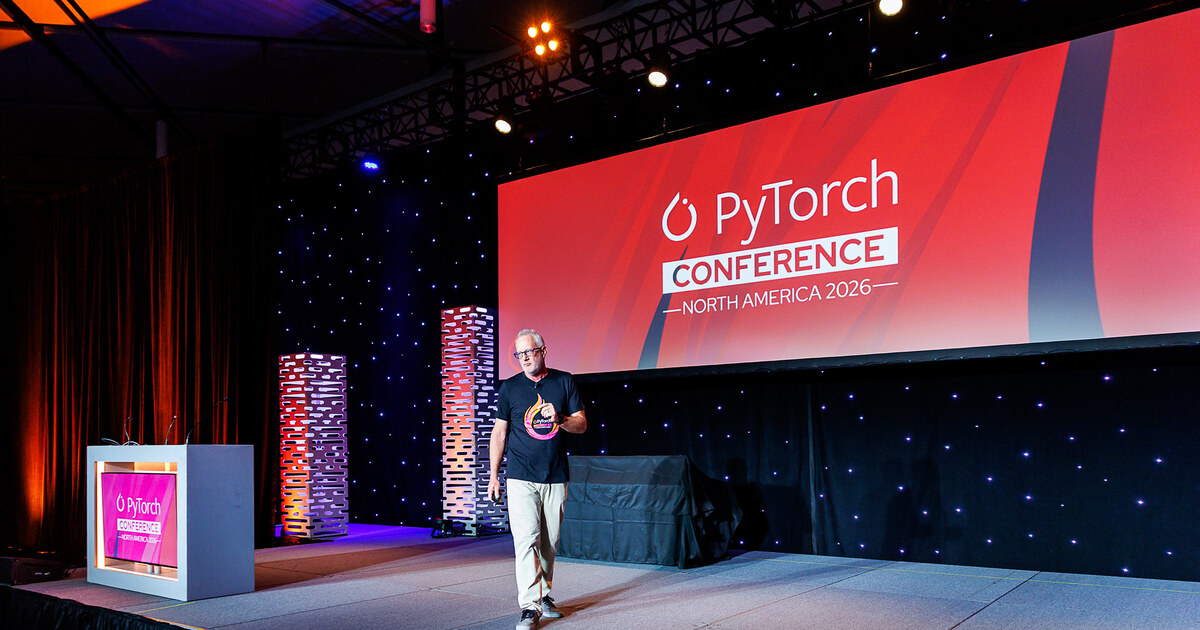
Google e Meta abriram o código de TorchTPU durante a PyTorch Conference North America 2026, realizada em San Jose no dia 21 de outubro. TorchTPU é um backend nativo do PyTorch para os Tensor Processing Units (TPUs) do Google, substituindo PyTorch/XLA de 2020, que segundo o anúncio "requeria modificações intrusivas do código-fonte".
O objetivo central do TorchTPU é simplificar a portabilidade de modelos entre dispositivos. A mudança necessária reduz-se a alterar model.to("cuda") para model.to("tpu"). Conforme afirmou Google Cloud, "com TorchTPU, TPUs se juntam a GPUs e CPUs como opção nativa para PyTorch". Meta planeja utilizar TorchTPU para mover workloads de LLM em larga escala para TPUs, conforme indicou Zongwei Zhou, engenheiro de software da Meta.
Imagem: InfoQ. TorchTPU integrado ao dispatcher PyTorch para suporte nativo a TPUs
Contexto de mercado e demanda
Mark Collier, diretor executivo da PyTorch Foundation, apresentou dados sobre mudanças no setor: inferência ultrapassou treinamento como o maior workload de data center, criando "uma demanda extraordinária por tokens". O mercado move-se com velocidade acelerada: o modelo Flash do DeepSeek ficou 60% mais barato em 37 dias, enquanto Kimi K3 rodou 68% mais rápido no mesmo hardware em 33 dias.
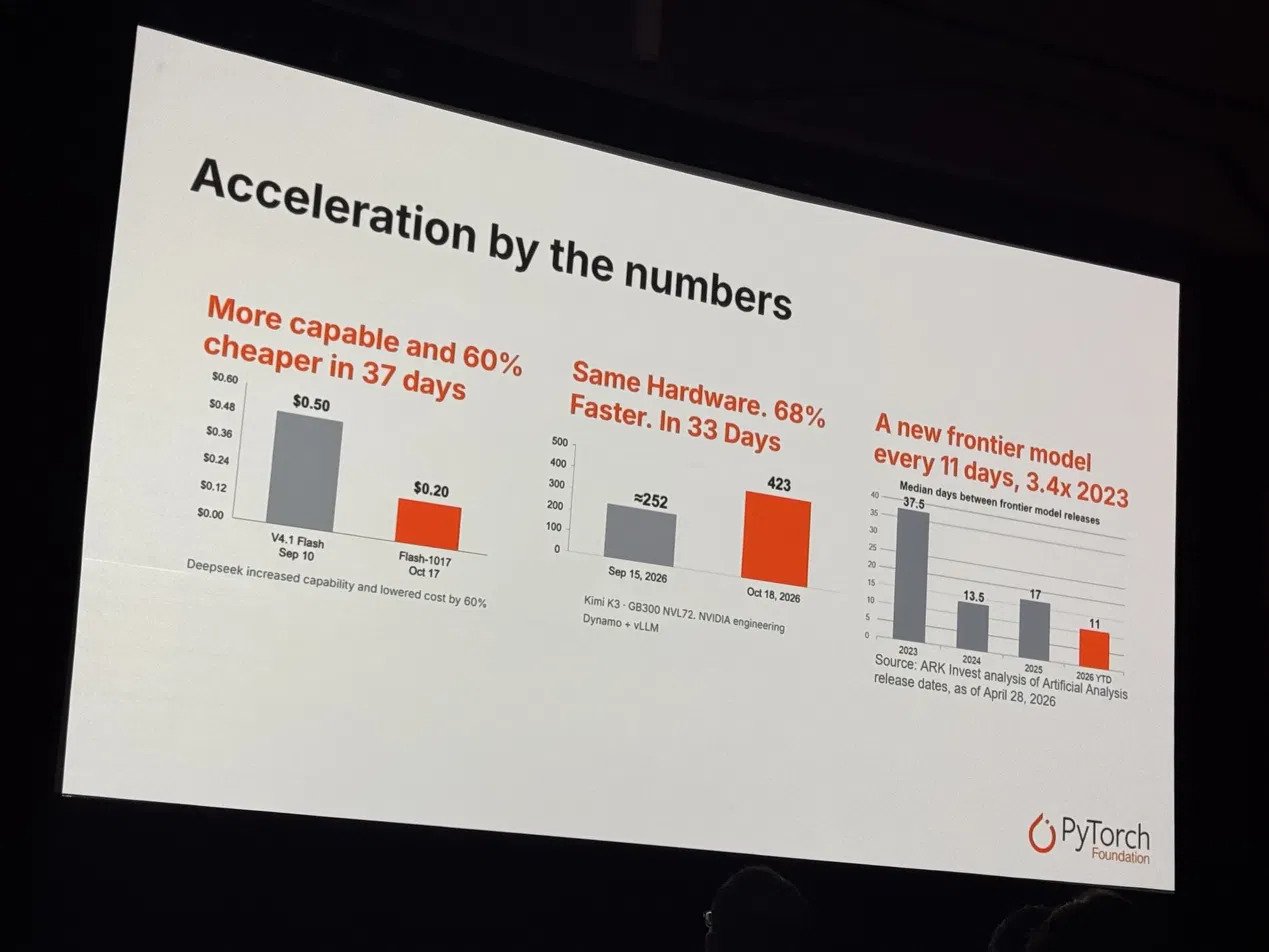
Imagem: InfoQ. Velocidade de evolução do mercado: DeepSeek Flash 60% mais barato em 37 dias, Kimi K3 68% mais rápido em 33 dias
Mazin Gilbert, diretor executivo da Agentic AI Foundation, reportou que o consumo de tokens por agentes de IA passou o consumo humano em 6 de fevereiro de 2026. Desde então, cresceu 14 vezes, em contraste com crescimento de 2,8 vezes para humanos. Esses números, porém, provêm de uma única plataforma, OpenRouter, exigindo verificação de escopo antes de generalização.
Funcionalidades e ecosistema
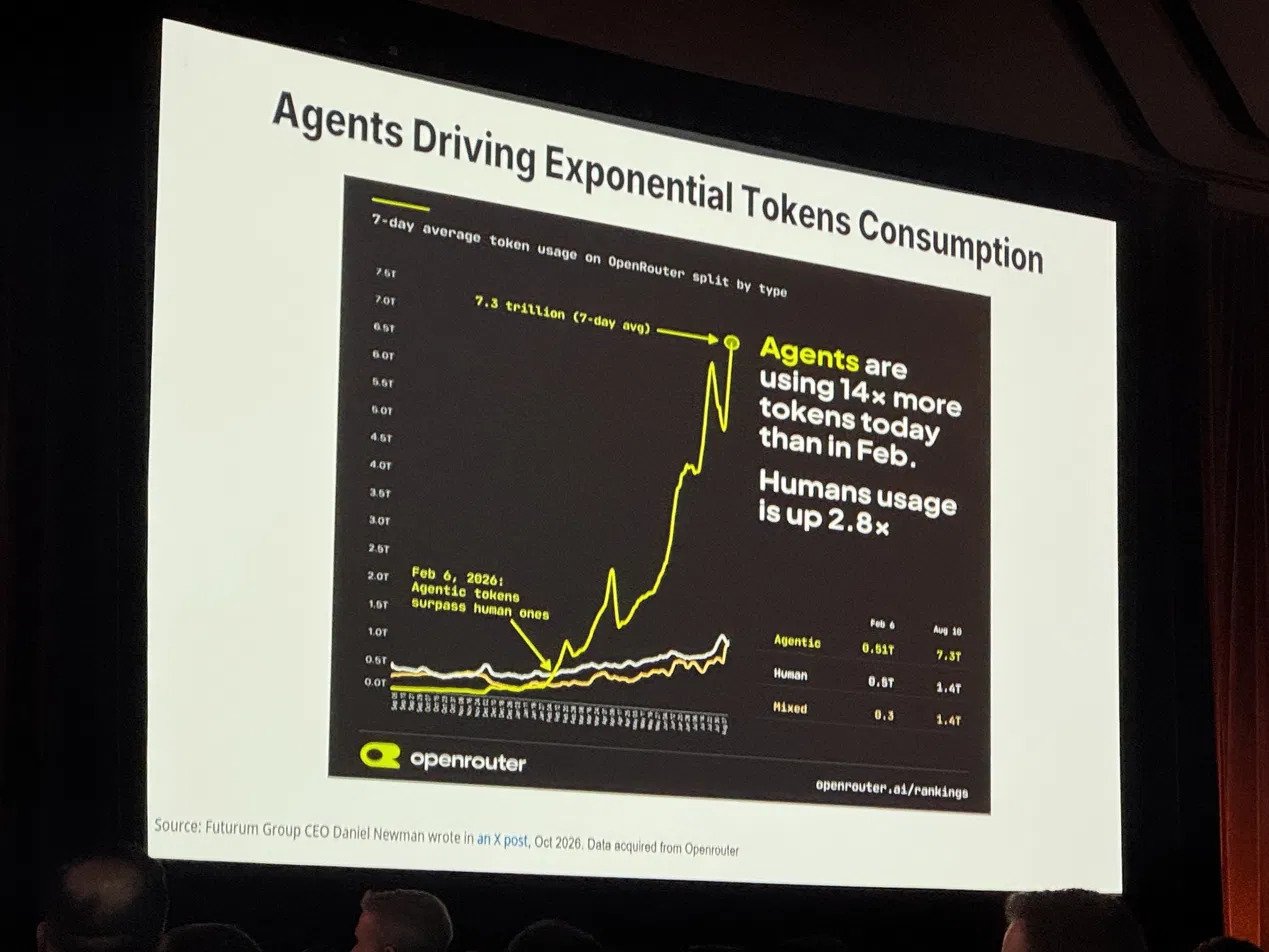
Imagem: InfoQ. Crescimento exponencial de consumo de tokens por agentes IA comparado ao consumo humano desde fevereiro de 2026
Por se integrar ao dispatcher de baixo nível do PyTorch, TorchTPU possibilita que modelos Hugging Face funcionem pronto para uso. Os motores de inferência vLLM e SGLang rodam nativamente, enquanto TorchTitan suporta treinamento em escala de modelos densos, mixture-of-experts e diffusion. Ray e llm-d orquestram workloads TPU em múltiplos hosts no Kubernetes. Quatro repositórios foram abertos: TorchTPU, vLLM-TorchTPU, SGLang-TorchTPU e TorchTitan.
Google demonstrou scaling quase-linear com mais de 8.000 chips TPU, mantendo throughput por-chip aproximadamente constante conforme o cluster crescia. Resultados publicados incluem execução de Qwen3 235B mixture-of-experts em 8.192 chips TPU v7x com 28% de utilização de model FLOPs. O anúncio reconhece que a mudança one-line é apenas ponto de partida: "não se pode alcançar performance de pico de TPU com essa mudança simples, já que as formas, sharding e operações de um modelo podem estar inclinadas para arquitetura GPU; porém, o modelo deve rodar pronto para uso."
Google respondeu a essa lacuna de otimização anunciando a TPU agent suite, agora em preview no GitHub, que automatiza onboarding, diagnóstico e otimização de performance plugando-se em harnesses de codificação.
Movimento paralelo da AWS e questões de vendor lock-in
Imagem: InfoQ. Escalabilidade linear de TorchTPU com mais de 8.000 chips TPU v7x mantendo throughput consistente
A AWS lançou TorchNeuron, backend nativo do PyTorch para chips Trainium, em beta público em 20 de outubro. TorchNeuron usa .to('neuron') como única mudança de código necessária, espelhando a abordagem do TorchTPU. Ambos backends se registram via PrivateUse1, o ponto de extensão oficial do PyTorch para hardware customizado.
Ainda assim, TorchNeuron apresenta limitações iniciais: não suporta dynamic input shapes em sua primeira release e pula aproximadamente 22.000 testes do PyTorch, conforme reportado por The Next Web. Blair Hayes argumentou em análise para Forkast que o vendor lock-in não desapareceu, mas deslocou-se: "Embora o ponto de extensão do PyTorch forneça uma linguagem comum para desenvolvedores, as camadas de otimização e supply permanecem firmemente sob controle dos vendedores".
Recepção comunitária
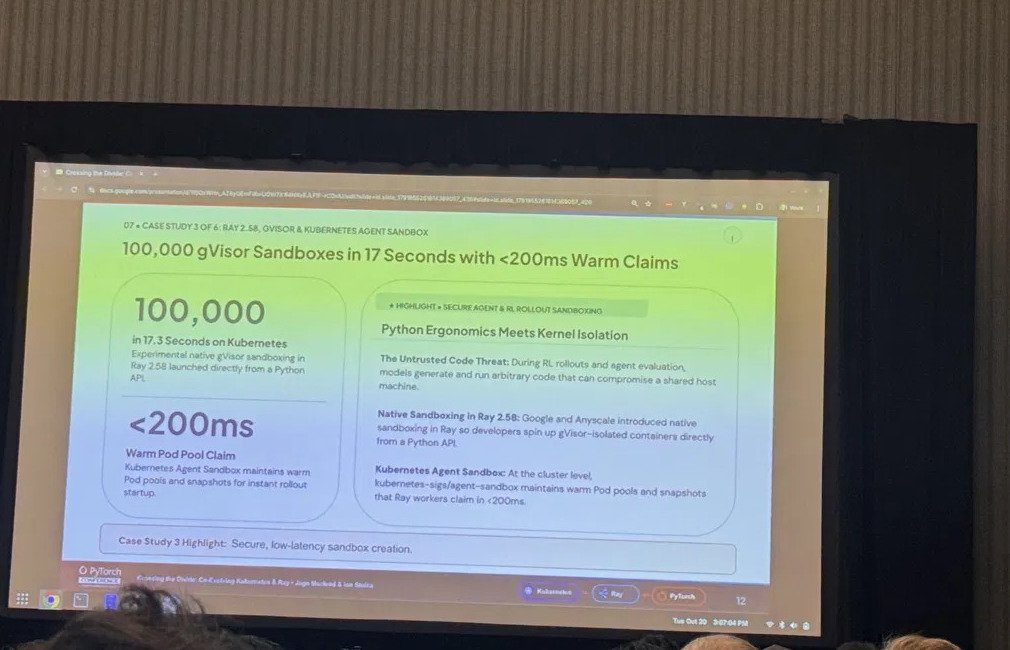
Imagem: InfoQ. Otimizações de kernel e delta updates: fusão de computações acelerando 10x e redução de dados de sync em 62 vezes
A thread do TorchTPU no Hacker News atingiu 379 pontos, com reações mistas. Um comentarista expressou alívio: "Lembro dos dias em que você tinha que lutar contra XLA para fazer PyTorch rodar em TPUs, parece que finalmente conseguimos suporte de primeira-festa!". Outros levantaram dúvidas práticas sobre disponibilidade de TPUs para compra. Uma empresa que avaliou TPUs on-premises optou por manter-se com Nvidia por mais uma geração.
Portabilidade além do data center
Imagem: InfoQ. ExecuTorch permitindo portabilidade de políticas PyTorch em múltiplas plataformas de hardware
ExecuTorch, plataforma de Meta, permite que políticas permaneçam em PyTorch desde o treinamento até o dispositivo, eliminando stack de conversão. Conforme argumentado por Anthony Shoumikhin e Jacob Szwejbka da Meta, as mesmas quantização e grafos de operadores rodam em TensorRT em NVIDIA Jetson até OpenVINO em Intel.
Progresso em treinamento e reforço
O Miles reinforcement learning framework, apresentado por Yueming Yuan de RadixArk, demonstrou otimizações significativas: fusão de duas computações de log-probability em um kernel acelerou aquela etapa em mais de 10 vezes. Delta updates reduziram dados movidos por weight sync de 62 GB para menos de 1 GB em uma execução grande.
SkyRL de Anyscale separa treinamento, inferência e ambientes, orquestrando com Ray. OpenEnv do Hugging Face, que se juntou à Agentic AI Foundation em 22 de outubro, fornece interface padronizada para cada ambiente RL. Usando TRL e OpenEnv, Sergio Paniego Blanco treinou modelo Liquid AI pequeno através de quatro agentes de código, elevando score em tarefas retidas de 42% para 54%.
Recomendações práticas
Para equipes considerando migração, a mudança one-line do device permite que o modelo rode mas não está otimizado. Recomenda-se orçamentar para sharding e trabalho de kernel e confirmar capacidade TPU disponível antes de empreender a migração. Gravações de sessões serão disponibilizadas no YouTube da PyTorch Foundation dentro de duas semanas do evento.